
Szakértői rovatunk
Jev modellről szakmailag: nem minden kérdéshez kell LLM
Jev modellről szakmailag: nem minden kérdéshez kell LLM

Hegedüs
Armand Alex
Bevezető
Amikor először tanultam a mély neuronhálókról, azt tanították nekem, hogy a betanított anyagokból kiindulva kétfajta feladat típus létezik, amit mesterséges neuronhálókkal oldunk meg: A Regresszió, azaz egy kérdésre akár a végtelen nagy számot is válaszként megadható becslés, valamint a Klasszifikáció, amikor több válaszból kell egyet megadni. Ehhez képest a ma használt modellek képeket generálnak, vagy szöveges elemzéseket nyújtanak a feladatainkra. Viszont a TypeSafe nevű cég új modellje, a sokat emlegetett Jev, a korábban említett klasszifikációt képes elvégezni; szembe helyezkedve a Nagy Nyelvi Modellekkel (LLM - Large Language Models) nem számítunk szöveges válaszra vagy kódra, csak három típusú érték közül egyre. Ezeket előre megszabjuk neki, hogy milyen kérdésre milyen válaszokat várunk. De mint említettem, ez volt az első fajtája az AI (Artificial Intelligence – Mesterséges Intelligencia) modelleknek, tehát akkor mi ebben az újdonság? Vagy miért figyeltek fel rá az AI fejlesztő cégek?
Az elmúlt napokban igyekeztem a végére járni a különlegességnek, és megválaszolni a kérdést, hogy vajon ez csak egy újabb "háromnapos csoda" modell vagy talán valamivel több? Saját Jev modellt készítettünk, valamint a DocAudit nevű termékünkre készített mérőeszközökkel összehasonlítottuk a képességeit mind a hagyományos LLM-eknek, mind pedig a Jev és saját Jev szerű modelleknek. De ne szaladjunk ennyire előre, először is nézzük meg honnan származik a probléma, amit Jev volt hivatott megoldani.
Mi a probléma?
Képzeljük el, hogy az iskolapadban ülünk, és éppen egy feleletválasztós kérdésen próbáljuk eldönteni, hogy A, B vagy esetleg C lesz-e a helyes válasz. Ha az "LLM" nevű padtársunkra pillantanánk meglepve tapasztalnánk, hogy egy teljes esszét ír éppen. Sajnos ő úgy gondolkodik, hogy először le kell vezetni egy esszében a problémát, az okokat, lehetséges megoldásokat, és ezt követően fog tudni csak kiválasztani a három opcióból egy darabot.
Előttünk azonban az új osztálytársunk ül, bizonyos "Jev", aki végigolvassa az összes kérdést, és meglepetésünkre mind a 20 kérdésre egy tollsuhintással egyszerre behúzta az X-et, mintha egyszerre 20 keze lenne.
Bár a példa kicsit szürreális, jól szemlélteti, hogy hogyan állnak neki a probléma megoldásának a különböző modellek. Nyilván az esszé írás hasznos, hogyha egy nagyon összetett problémát kell megoldani, például ha levezetést írunk egy matematikai feladatnál is. Ezzel szemben a feleletválasztós feladatok általában egyszerű, azonnal eldönthető kérdéseket takarnak (már amennyiben tanult az ember/modell). És a számítógépes programok apró döntéseinél hasonló feleletválasztásra van szükség: "Veszélyes ez a parancs?", "Milyen kategóriába tartozik ez a dokumentum?", "Mennyire releváns ez a találat?" - De esszét írni az összes kérdésre igencsak felesleges lenne...
A nagy nyelvi modellek akkor is tokenről-tokenre fognak "gondolkodni", ha csak annyi a válasz, hogy "Helyes opció a B." Ez a tokenenkénti feldolgozás felesleges késleltetést és extra költséget jelent. Ráadásul a rendszer abban sem biztos, hogy jó irányba halad-e, ha konfidenciát szeretnénk megbecsülni, akkor arra jelenleg egy másik modellt vagy valami objektív mérőeszközt kell igénybe venni, ami még nagyobb költséget és késleltetést jelent. Ezek összeadódnak, amikor egy Agent egy feladat közben több tucatszor hívja meg a modellt. Arról nem is beszélve, hogy ha nem elég okos a választott AI, akkor sokszor még az se biztos, hogy megfelelő formátumban adja vissza a választ amit a gép ki tudna olvasni (json struktúra szintaktikus hibái), ilyenkor az egyetlen lehetőség, hogy további modell hívásokkal javítjuk ezt ki.
Mit javasol a TypeSafe?
A TypeSafe-nél egy olyan modellt szerettek volna alkotni, ami feladja ugyan a lehetőséget a szöveges válaszadásra vagy a komplex megoldás kigondolására, de cserébe szintaktikus hiba lehetősége nélkül, csak az előre megadott lehetséges opciókból ad magabiztos választ (vagy legalább jelzi ha bizonytalan).Mindemellett nevetségesen gyors és olcsó: a gyártó szerint 70-500 ms válaszidővel és 0,042 USD / millió bemeneti token költséggel lehet számolni náluk, ami ha igaz akár 200x gyorsabb mint a hagyományos LLM-ek és akár 400x olcsóbbak is! Ráadásul a kimenet generálása annyira triviális számukra, hogy azért nem is kérnek pénzt, míg a nagy nyelvi modelleknél az az egyik legdrágább része a modelleknek.
Bár eddig is léteztek olyan modellek, amik szöveget olvastak és ez alapján képesek voltak klasszifikálni különböző kérdés-válasz kombinációkat, ezeket sokszor kérdésenként kell tanítani saját tanítóadattal és egyáltalán nem voltak ennyire az általános tudástérben jártasak. Arról nem is beszélve, hogy a saját magabiztosságukról túlzottan is biztos vagy éppen teljesen következetlen értékelést nyújtanak. Ezzel szemben a Jev szinte bármilyen területen kérdezhető, ráadásul rögtön három fajta kérdésre is tud választ adni.
Hogyan működik?
Mint azt említettük, a Jev modell nem képes beszélgetni vagy szabad szöveges választ írni, helyette azt kéri, hogy adjuk meg neki a jelenlegi helyzet leírását (Szöveg vagy JSON) ami alapján megérti, hogy mire vonatkozik a kérdés. Ezt követően kéri a kérdéseket, amelyek válaszformáit mi magunk előre rögzítjük. Ezekhez a kérdésekhez megadhatjuk, hogy például Choice típusú legyen a válasz, azaz megadunk egy listányi opciót és azok közül kell, hogy helyesen válasszon a modell. Alternatívaképpen választhatjuk a Score típust, ami azt jelenti, hogy egy általunk megadott skálán helyezi el a választ, aminek a lépcsőfokait kifejtjük. Ha pedig eldöntendő kérdést szeretnénk feltenni, akkor a Noul kimenet fogja megmondani mennyire az igen vagy a nem felé hajlik Jev. Ezekhez minden esetben külön-külön ad konfidenciaszintet is, aminek a pontosságára speciális tanítási módszert fejlesztett ki a TypeSafe (és persze a válaszok helyessége miatt is).
Érdekes dolog ez a konfidenciaérték, ugyanis nem azt jelenti, hogy a modell magas konfidencia esetén biztos helyes. Bár a TypeSafe fontos képességként hozza fel, hogy hallucinálni nem képes a modelljük, ami tényszerűen igaz a működéséből fakadóan, de ez nem azt jelenti, hogy nem tudja rámondani a fű színére, hogy piros. Ez csak annyit jelent, hogy amit mi megadunk válaszlehetőségként csak azokat adhatja vissza és semmi mást. Ha pedig magas a konfidencia, akkor a modell a tanult módszerek alapján és a kontextus ismeretében adja meg a saját valódi bizonyosságát, ami nem egyenlő a hitelességgel. A bizonyosság azért hasznos, mert a modell így jelezni tudja, hogy külső segítségre szorul.(például egy nagyobb LLM modellre vagy emberi ellenőrzésre van szüksége).
Viszont míg az alcímünk, azt a kérdést teszi fel, hogyan működik Jev, addig sajnos a teljes választ nem ismerjük. Ezeket a TypeSafe nem tette nyilvánossá, hiszen Jev egy zártkörű modell. Sok csoport próbálja megfejteni, hogyan működik, és számos jó tipp született már. Azonban nem lepődünk meg azon, hogy ezt nem szeretnék az üzleti érték miatt megosztani, elvégre csupán két héttel a modell megjelenése után, az OpenAI már be is jelentette, hogy ők is csinálnak saját Jev-et (OpenAI Decisions), nehogy lemaradjanak.
Mit jelent a Jev szerű modell a felhasználóknak?
Ez az új modell azt teszi egyértelművé, hogy a szövegek generálásnak és a döntéshozatalnak az esetek döntő többségében különálló feladatba kell tartozniuk.A Jev szerű modellek kimagaslanak az egyszerű döntések meghozásában. Emiatt a komplex feladatoknál az - LLM-ekkel együttműködve - át tudja venni könnyű kérdésekre a válasz adás szerepét, míg a nagy nyelvi modellek az összetett válaszokat alkotják meg. Működik az is, hogy az LLM tervez, Jev pedig irányít, szűr és ellenőriz.
Hol érdemes használni Jev-et?Csak hogy néhány példát említsünk: Zárt körű válaszhalmaznál, gyakori döntéseknél, gyorsan címkézhető példáknál (osztályozás vagy routing), relevancia-szűrésnél, szemantikai ellenőrzésnél vagy kockázati besorolásnál.
És hol nem érdemes? Szövegírásnál, összegzésnél, kódolásnál vagy magyarázatoknál egyáltalán nem, hisz ezek LLM-re való feladatok. De számítást igénylő feladatoknál, ismeretlen értékek kinyerésénél vagy többlépéses érvelésnél sem érdemes. Sőt, ha valamit egyszerű elágazásokkal vagy programkóddal el lehet dönteni, akkor sem a Jev-et érdemes választani, mert az túl egyszerű feladat ahhoz hogy ezzel a modellel "lassítsuk".
Miért éreztük a szükségét, hogy beszéljünk erről a modellről? Ahogy a Hugging Face egyik mérnökének gúnyos X-bejegyzését és az arra érkező egyetértő reakciókat olvastuk, úgy éreztük, hogy sokan nem látják még a mérnökök között sem, hogy ennek hol van értéke és hol nincs. A Jev előnyeinek és hátrányainak kikutatása után mi is látjuk, hogy hol képez értéket ez a technológia: a DocAudit mesterséges intelligenciával támogatott dokumentum feldolgozó rendszerünk számos olyan feladatot végez el, amik a Jev által jelentősen gyorsíthatóak. Ezeknél a feladatoknál nem technológiai akadályba ütköztünk, hiszen megoldást a mai tudománnyal a legtöbb problémára tudunk szolgáltatni. A valódi probléma az volt, hogy mennyi idő alatt végzi ezt el a rendszer. A dokumentumok számossága miatt az egyik esetben több hetes feldolgozási idővel kellett volna számolni, pontosan a nyelvi modellek érvelési képességei miatt. Ennek jelentős részét egyszerűbb statisztikai modellekkel vagy vektoros elemzések segítségével felgyorsítottuk, de bizonyos kérdésekben így a mínőségből vesztettünk. A Jev jellegű modellek rávilágítottak arra, hogy nincs szükség minden kérdés újratanítására, lehet általánosabb klasszifikálókat is készíteni, amit mi már el is kezdtünk alkalmazni. Sőt, a lokalitás szempontjából nem csak ezeket a módszereket hasonlítottuk össze, hanem a saját magunk által átalakított, magyar nyelvű, Jev-szerű modellt is.
Mit építettünk?
Hogy ne csak a gyártó ígéreteire hagyatkozzunk, két dolgot építettünk:
egy saját DocAudit-benchmarkot és egy saját, lokálisan futtatható, Jev-szerű modellt.
A) Saját benchmark a DocAudit-feladatokra
A gyártói számok általános vagy ismeretlen feladatokra vonatkoznak. A mi felhasználásunkban lehet hogy jelentősen alul teljesítene Jev az általános LLM-ekhez képest. Ezért saját, valódi felhasználásból származó példatáron és azok előre megadott válaszain kell kivizsgálnunk a modellek sikerességét. A méréseink a pontosságot, a konfidenciaszint valódi válaszokhoz való arányát, az igaz-hamis állítások közti jó elkülöníthetőséget, a sebességet és a költséget mérték, valamint azt, hogy hogyan aránylik a sikerráta magyar és angol nyelvű adatoktól függően. A példák jellemzően olyan feladatokat látnak el, mint a dokumentumok klasszifikációja, kötelező elemek vizsgálata, forráselemzés és az emberi közbelépés szükségességének felmérése. Ezeket a feladatokat a Jev-féle modellek jellemzően jól tudják kezelni.
B) Saját, lokálisan futtatható Jev-szerű modell
A belső teszteléseinkhez átalakítottuk az ELTE kutatói által finomhangolt Racka modell-t, hogy a Jev-hez hasonlóan, csak a fent említett három válaszlehetőséget adja meg. Az eredeti modellt azokkal a módszerekkel alakítottuk át, mint amikkel szerintünk a Jev-et is előállították. Bár a modell méretéből fakadóan egyértelmű volt, hogy gyengébb eredmények fognak születni, itt a célunk az volt, hogy lokalitási szempontból lássuk, életképes lehet-e egy egyszerű laptopon futtatható modellt használatba állítani.Az eredményen kellemesen meglepődtünk.
FONTOS megemlíteni, hogy mi itt nem tanítottunk vagy finomhangoltunk modellt, csupán az architektúráján változtattunk, ez viszont azt jelenti, ahogy később látni fogjuk, hogy specifikus tanítást követően ez is kínálhat számos feladatban alternatívát.
Hogyan teszteltünk?
Ugyanazokat a DocAudit feladatokat adtuk oda hét versenyzőnek. Öt nyelvi modell, névszerint: GPT-5.6-luna, GPT-5.6-terra, GPT-6-luna, Claude Haiku 4.5, Claude Sonnet 5.5. Ezentúl kettő Jev szerű modellel is mértünk: az eredeti Jev és a saját magunk által készített Racka-Jev modellen. Összevetettük ezeket egy véletlenszerűen tippelő alapvonallal, amit főleg a kis modell teszteléséhez vezettünk be, végül pedig az összes eredményt felhasználva, kimutatásokkal néztük meg a modellek képességeit.
Teszteltünk ezentúl valószínűséget vagy konfidenciát, hiszen az LLM-ek nem tudják a saját valószínűségüket jól megbecsülni, de látni szerettük volna, hogy vajon a Jev szerű modellek jobban végzik-e a feladatukat.
Mit mutattak az eredmények?
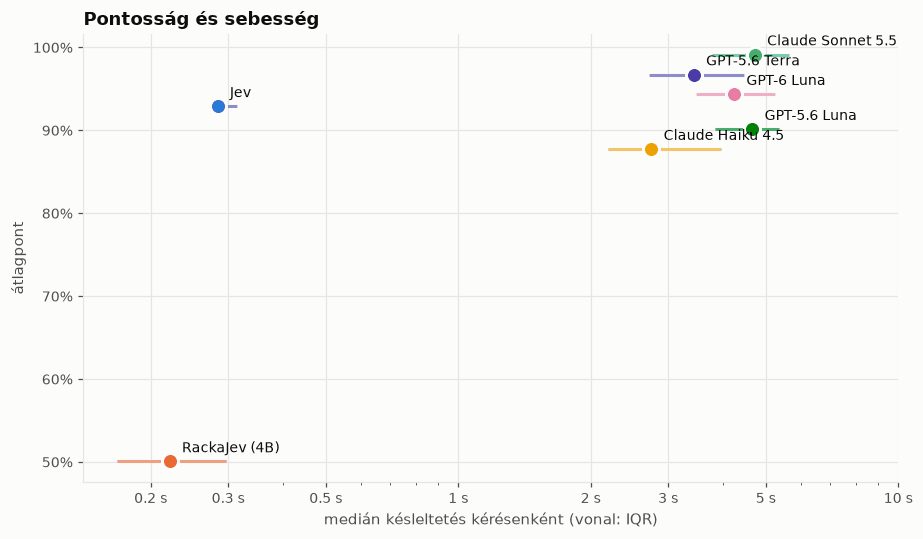
Az első eredmények az átlagos pontosságra vonatkoztak. Ezek alapján azt figyelhetjük meg, hogy a Jev sebessége ellenére rendkívül jól tartja magát, valahol a kis gpt-luna és közepes gpt-terra méretű modellek között helyezkedik el,bár a gpt-6-luna egyértelműen okosabb mint az elődje. A tesztelt Racka-Jev, pici mérete és feladattípuson való alultanítottsága miatt jelentősen gyengébb eredményt mutatott, viszont mint ahogy az ábrán látható se a naiv (mindig az általános, első vagy középső válaszokat választjuk ki), se pedig a véletlen szerű válaszadás közelében sem volt, így következtethetünk valódi intelligens döntéshozatalra.

Szemben a pontossággal a TypeSafe állításai szerint a legnagyobb előnye a Jev szerű modelleknek a sebességük. Bár a saját esetünkben több százszoros sebesség növekedést nem láttunk, a nagy nyelvi modellekhez képest átlagosan legalább 10-szer gyorsabban hozták meg ezeket a döntéseket a Jev szerű modellek, és a helyi Racka-Jev modellünk a lokalitásnak köszönhetően még az eredeti Jevet is megelőzte.
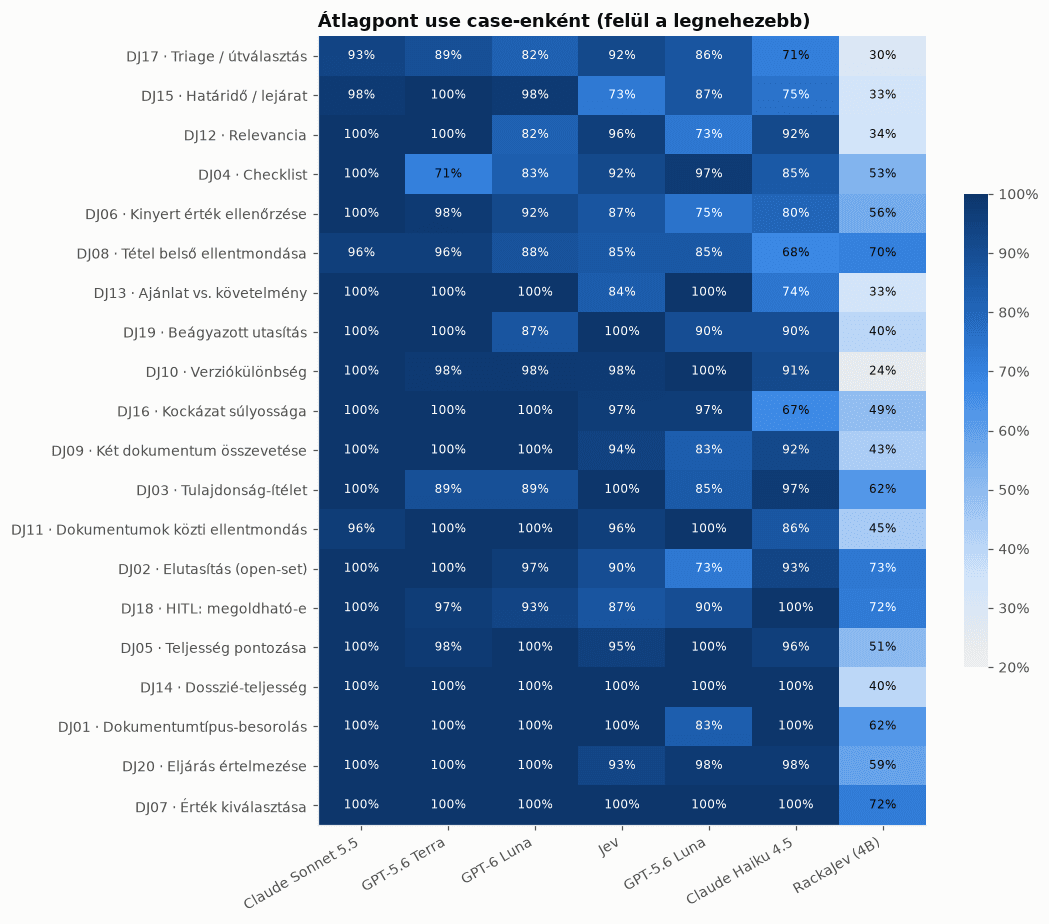
Két további hasznos adat amikről érdemes beszélni: A feladatonkénti pontosság lebontás, már most is működik. Ez azt mutatja, hogy még az alulméretezett és tanítás nélküli RackaJev is képes bizonyos feladatokat (például az embereknek szükséges információ jelzését) ellátni..
A másik érdekes adat, hogy hogyan változtat az angol vagy magyar nyelv az elért eredményeken ugyanazon feladatokban. Itt jól látható, hogy jelentős a javulás, több mint 5% változik a RackaJev esetében, ami szintén arra mutat, hogy további finomhangolás jelentős javulást eredményezne.

Érdemes azt is megemlíteni, hogy a gpt-luna modellek és a claude haiku modell a tesztelés során a kérdések közel 8-12%-ra nem is generáltak helyesen értelmezhető választ a megfelelő JSON struktúrában. Azaz ilyenkor nem a pontossága miatt volt helytelen az eredmény, hanem mert a válasz szintaktikailag helytelen volt.
Végül a konfidencia mérésünk. Sajnos a RackaJev esetén láttuk, hogy extra tanítás nélkül, nem képes a modell saját magára helyesen konfidenciát tippelni. Viszont ezt a Jev esetében megtették, ezért legyőzte az összes tesztelt nagy nyelvi modellt. Az ábrát úgy érdemes nézni, hogy mennyire jól követik a modellek az átlós vonalat.

Milyen következtetést vontunk le ebből?
Két dolgot biztosan le lehet vonni már ezekből az adatokból. Az általunk végzett irodai (specifikusan DocAudit típusú) feladatokon, a Jev, nemcsak hogy több tizenvalahányszoros sebességet kínál, de a válaszok pontosságában is versenyképes marad. Ezentúl nem képes olyan választ adni, amit nem kértünk, vagyis elkerüli azokat a hibákat is, mint amiket a pici nyelvi modellek okoztak.
A Jev használata a saját termékünkben egyértelműen hasznos lesz, akár több napnyi erőforráshasználatot képes lecsökkenteni néhány órára egy teljes projekt kezelése során. Ami külön érdekes, hogy minimális változtatással egy személyre szabott lokális modell, pláne célfeladatra előkészítve és továbbtanítva, szintén adhat megoldást erre a problémára. Ez azért is jó hír, mert így azon cégek számára, akiknek az adatbiztonság védelme érdekében az EGT-n belüli adatfeldolgozás sem elfogadható, hanem kifejezetten irodán belül kell, hogy maradjon az adat. Kaptak egy új lokális és megfelelő hardver mellett futtatható DocAudit megoldást, Jev típusú feladatokra.
Bevezető
Amikor először tanultam a mély neuronhálókról, azt tanították nekem, hogy a betanított anyagokból kiindulva kétfajta feladat típus létezik, amit mesterséges neuronhálókkal oldunk meg: A Regresszió, azaz egy kérdésre akár a végtelen nagy számot is válaszként megadható becslés, valamint a Klasszifikáció, amikor több válaszból kell egyet megadni. Ehhez képest a ma használt modellek képeket generálnak, vagy szöveges elemzéseket nyújtanak a feladatainkra. Viszont a TypeSafe nevű cég új modellje, a sokat emlegetett Jev, a korábban említett klasszifikációt képes elvégezni; szembe helyezkedve a Nagy Nyelvi Modellekkel (LLM - Large Language Models) nem számítunk szöveges válaszra vagy kódra, csak három típusú érték közül egyre. Ezeket előre megszabjuk neki, hogy milyen kérdésre milyen válaszokat várunk. De mint említettem, ez volt az első fajtája az AI (Artificial Intelligence – Mesterséges Intelligencia) modelleknek, tehát akkor mi ebben az újdonság? Vagy miért figyeltek fel rá az AI fejlesztő cégek?
Az elmúlt napokban igyekeztem a végére járni a különlegességnek, és megválaszolni a kérdést, hogy vajon ez csak egy újabb "háromnapos csoda" modell vagy talán valamivel több? Saját Jev modellt készítettünk, valamint a DocAudit nevű termékünkre készített mérőeszközökkel összehasonlítottuk a képességeit mind a hagyományos LLM-eknek, mind pedig a Jev és saját Jev szerű modelleknek. De ne szaladjunk ennyire előre, először is nézzük meg honnan származik a probléma, amit Jev volt hivatott megoldani.
Mi a probléma?
Képzeljük el, hogy az iskolapadban ülünk, és éppen egy feleletválasztós kérdésen próbáljuk eldönteni, hogy A, B vagy esetleg C lesz-e a helyes válasz. Ha az "LLM" nevű padtársunkra pillantanánk meglepve tapasztalnánk, hogy egy teljes esszét ír éppen. Sajnos ő úgy gondolkodik, hogy először le kell vezetni egy esszében a problémát, az okokat, lehetséges megoldásokat, és ezt követően fog tudni csak kiválasztani a három opcióból egy darabot.
Előttünk azonban az új osztálytársunk ül, bizonyos "Jev", aki végigolvassa az összes kérdést, és meglepetésünkre mind a 20 kérdésre egy tollsuhintással egyszerre behúzta az X-et, mintha egyszerre 20 keze lenne.
Bár a példa kicsit szürreális, jól szemlélteti, hogy hogyan állnak neki a probléma megoldásának a különböző modellek. Nyilván az esszé írás hasznos, hogyha egy nagyon összetett problémát kell megoldani, például ha levezetést írunk egy matematikai feladatnál is. Ezzel szemben a feleletválasztós feladatok általában egyszerű, azonnal eldönthető kérdéseket takarnak (már amennyiben tanult az ember/modell). És a számítógépes programok apró döntéseinél hasonló feleletválasztásra van szükség: "Veszélyes ez a parancs?", "Milyen kategóriába tartozik ez a dokumentum?", "Mennyire releváns ez a találat?" - De esszét írni az összes kérdésre igencsak felesleges lenne...
A nagy nyelvi modellek akkor is tokenről-tokenre fognak "gondolkodni", ha csak annyi a válasz, hogy "Helyes opció a B." Ez a tokenenkénti feldolgozás felesleges késleltetést és extra költséget jelent. Ráadásul a rendszer abban sem biztos, hogy jó irányba halad-e, ha konfidenciát szeretnénk megbecsülni, akkor arra jelenleg egy másik modellt vagy valami objektív mérőeszközt kell igénybe venni, ami még nagyobb költséget és késleltetést jelent. Ezek összeadódnak, amikor egy Agent egy feladat közben több tucatszor hívja meg a modellt. Arról nem is beszélve, hogy ha nem elég okos a választott AI, akkor sokszor még az se biztos, hogy megfelelő formátumban adja vissza a választ amit a gép ki tudna olvasni (json struktúra szintaktikus hibái), ilyenkor az egyetlen lehetőség, hogy további modell hívásokkal javítjuk ezt ki.
Mit javasol a TypeSafe?
A TypeSafe-nél egy olyan modellt szerettek volna alkotni, ami feladja ugyan a lehetőséget a szöveges válaszadásra vagy a komplex megoldás kigondolására, de cserébe szintaktikus hiba lehetősége nélkül, csak az előre megadott lehetséges opciókból ad magabiztos választ (vagy legalább jelzi ha bizonytalan).Mindemellett nevetségesen gyors és olcsó: a gyártó szerint 70-500 ms válaszidővel és 0,042 USD / millió bemeneti token költséggel lehet számolni náluk, ami ha igaz akár 200x gyorsabb mint a hagyományos LLM-ek és akár 400x olcsóbbak is! Ráadásul a kimenet generálása annyira triviális számukra, hogy azért nem is kérnek pénzt, míg a nagy nyelvi modelleknél az az egyik legdrágább része a modelleknek.
Bár eddig is léteztek olyan modellek, amik szöveget olvastak és ez alapján képesek voltak klasszifikálni különböző kérdés-válasz kombinációkat, ezeket sokszor kérdésenként kell tanítani saját tanítóadattal és egyáltalán nem voltak ennyire az általános tudástérben jártasak. Arról nem is beszélve, hogy a saját magabiztosságukról túlzottan is biztos vagy éppen teljesen következetlen értékelést nyújtanak. Ezzel szemben a Jev szinte bármilyen területen kérdezhető, ráadásul rögtön három fajta kérdésre is tud választ adni.
Hogyan működik?
Mint azt említettük, a Jev modell nem képes beszélgetni vagy szabad szöveges választ írni, helyette azt kéri, hogy adjuk meg neki a jelenlegi helyzet leírását (Szöveg vagy JSON) ami alapján megérti, hogy mire vonatkozik a kérdés. Ezt követően kéri a kérdéseket, amelyek válaszformáit mi magunk előre rögzítjük. Ezekhez a kérdésekhez megadhatjuk, hogy például Choice típusú legyen a válasz, azaz megadunk egy listányi opciót és azok közül kell, hogy helyesen válasszon a modell. Alternatívaképpen választhatjuk a Score típust, ami azt jelenti, hogy egy általunk megadott skálán helyezi el a választ, aminek a lépcsőfokait kifejtjük. Ha pedig eldöntendő kérdést szeretnénk feltenni, akkor a Noul kimenet fogja megmondani mennyire az igen vagy a nem felé hajlik Jev. Ezekhez minden esetben külön-külön ad konfidenciaszintet is, aminek a pontosságára speciális tanítási módszert fejlesztett ki a TypeSafe (és persze a válaszok helyessége miatt is).
Érdekes dolog ez a konfidenciaérték, ugyanis nem azt jelenti, hogy a modell magas konfidencia esetén biztos helyes. Bár a TypeSafe fontos képességként hozza fel, hogy hallucinálni nem képes a modelljük, ami tényszerűen igaz a működéséből fakadóan, de ez nem azt jelenti, hogy nem tudja rámondani a fű színére, hogy piros. Ez csak annyit jelent, hogy amit mi megadunk válaszlehetőségként csak azokat adhatja vissza és semmi mást. Ha pedig magas a konfidencia, akkor a modell a tanult módszerek alapján és a kontextus ismeretében adja meg a saját valódi bizonyosságát, ami nem egyenlő a hitelességgel. A bizonyosság azért hasznos, mert a modell így jelezni tudja, hogy külső segítségre szorul.(például egy nagyobb LLM modellre vagy emberi ellenőrzésre van szüksége).
Viszont míg az alcímünk, azt a kérdést teszi fel, hogyan működik Jev, addig sajnos a teljes választ nem ismerjük. Ezeket a TypeSafe nem tette nyilvánossá, hiszen Jev egy zártkörű modell. Sok csoport próbálja megfejteni, hogyan működik, és számos jó tipp született már. Azonban nem lepődünk meg azon, hogy ezt nem szeretnék az üzleti érték miatt megosztani, elvégre csupán két héttel a modell megjelenése után, az OpenAI már be is jelentette, hogy ők is csinálnak saját Jev-et (OpenAI Decisions), nehogy lemaradjanak.
Mit jelent a Jev szerű modell a felhasználóknak?
Ez az új modell azt teszi egyértelművé, hogy a szövegek generálásnak és a döntéshozatalnak az esetek döntő többségében különálló feladatba kell tartozniuk.A Jev szerű modellek kimagaslanak az egyszerű döntések meghozásában. Emiatt a komplex feladatoknál az - LLM-ekkel együttműködve - át tudja venni könnyű kérdésekre a válasz adás szerepét, míg a nagy nyelvi modellek az összetett válaszokat alkotják meg. Működik az is, hogy az LLM tervez, Jev pedig irányít, szűr és ellenőriz.
Hol érdemes használni Jev-et?Csak hogy néhány példát említsünk: Zárt körű válaszhalmaznál, gyakori döntéseknél, gyorsan címkézhető példáknál (osztályozás vagy routing), relevancia-szűrésnél, szemantikai ellenőrzésnél vagy kockázati besorolásnál.
És hol nem érdemes? Szövegírásnál, összegzésnél, kódolásnál vagy magyarázatoknál egyáltalán nem, hisz ezek LLM-re való feladatok. De számítást igénylő feladatoknál, ismeretlen értékek kinyerésénél vagy többlépéses érvelésnél sem érdemes. Sőt, ha valamit egyszerű elágazásokkal vagy programkóddal el lehet dönteni, akkor sem a Jev-et érdemes választani, mert az túl egyszerű feladat ahhoz hogy ezzel a modellel "lassítsuk".
Miért éreztük a szükségét, hogy beszéljünk erről a modellről? Ahogy a Hugging Face egyik mérnökének gúnyos X-bejegyzését és az arra érkező egyetértő reakciókat olvastuk, úgy éreztük, hogy sokan nem látják még a mérnökök között sem, hogy ennek hol van értéke és hol nincs. A Jev előnyeinek és hátrányainak kikutatása után mi is látjuk, hogy hol képez értéket ez a technológia: a DocAudit mesterséges intelligenciával támogatott dokumentum feldolgozó rendszerünk számos olyan feladatot végez el, amik a Jev által jelentősen gyorsíthatóak. Ezeknél a feladatoknál nem technológiai akadályba ütköztünk, hiszen megoldást a mai tudománnyal a legtöbb problémára tudunk szolgáltatni. A valódi probléma az volt, hogy mennyi idő alatt végzi ezt el a rendszer. A dokumentumok számossága miatt az egyik esetben több hetes feldolgozási idővel kellett volna számolni, pontosan a nyelvi modellek érvelési képességei miatt. Ennek jelentős részét egyszerűbb statisztikai modellekkel vagy vektoros elemzések segítségével felgyorsítottuk, de bizonyos kérdésekben így a mínőségből vesztettünk. A Jev jellegű modellek rávilágítottak arra, hogy nincs szükség minden kérdés újratanítására, lehet általánosabb klasszifikálókat is készíteni, amit mi már el is kezdtünk alkalmazni. Sőt, a lokalitás szempontjából nem csak ezeket a módszereket hasonlítottuk össze, hanem a saját magunk által átalakított, magyar nyelvű, Jev-szerű modellt is.
Mit építettünk?
Hogy ne csak a gyártó ígéreteire hagyatkozzunk, két dolgot építettünk:
egy saját DocAudit-benchmarkot és egy saját, lokálisan futtatható, Jev-szerű modellt.
A) Saját benchmark a DocAudit-feladatokra
A gyártói számok általános vagy ismeretlen feladatokra vonatkoznak. A mi felhasználásunkban lehet hogy jelentősen alul teljesítene Jev az általános LLM-ekhez képest. Ezért saját, valódi felhasználásból származó példatáron és azok előre megadott válaszain kell kivizsgálnunk a modellek sikerességét. A méréseink a pontosságot, a konfidenciaszint valódi válaszokhoz való arányát, az igaz-hamis állítások közti jó elkülöníthetőséget, a sebességet és a költséget mérték, valamint azt, hogy hogyan aránylik a sikerráta magyar és angol nyelvű adatoktól függően. A példák jellemzően olyan feladatokat látnak el, mint a dokumentumok klasszifikációja, kötelező elemek vizsgálata, forráselemzés és az emberi közbelépés szükségességének felmérése. Ezeket a feladatokat a Jev-féle modellek jellemzően jól tudják kezelni.
B) Saját, lokálisan futtatható Jev-szerű modell
A belső teszteléseinkhez átalakítottuk az ELTE kutatói által finomhangolt Racka modell-t, hogy a Jev-hez hasonlóan, csak a fent említett három válaszlehetőséget adja meg. Az eredeti modellt azokkal a módszerekkel alakítottuk át, mint amikkel szerintünk a Jev-et is előállították. Bár a modell méretéből fakadóan egyértelmű volt, hogy gyengébb eredmények fognak születni, itt a célunk az volt, hogy lokalitási szempontból lássuk, életképes lehet-e egy egyszerű laptopon futtatható modellt használatba állítani.Az eredményen kellemesen meglepődtünk.
FONTOS megemlíteni, hogy mi itt nem tanítottunk vagy finomhangoltunk modellt, csupán az architektúráján változtattunk, ez viszont azt jelenti, ahogy később látni fogjuk, hogy specifikus tanítást követően ez is kínálhat számos feladatban alternatívát.
Hogyan teszteltünk?
Ugyanazokat a DocAudit feladatokat adtuk oda hét versenyzőnek. Öt nyelvi modell, névszerint: GPT-5.6-luna, GPT-5.6-terra, GPT-6-luna, Claude Haiku 4.5, Claude Sonnet 5.5. Ezentúl kettő Jev szerű modellel is mértünk: az eredeti Jev és a saját magunk által készített Racka-Jev modellen. Összevetettük ezeket egy véletlenszerűen tippelő alapvonallal, amit főleg a kis modell teszteléséhez vezettünk be, végül pedig az összes eredményt felhasználva, kimutatásokkal néztük meg a modellek képességeit.
Teszteltünk ezentúl valószínűséget vagy konfidenciát, hiszen az LLM-ek nem tudják a saját valószínűségüket jól megbecsülni, de látni szerettük volna, hogy vajon a Jev szerű modellek jobban végzik-e a feladatukat.
Mit mutattak az eredmények?
Az első eredmények az átlagos pontosságra vonatkoztak. Ezek alapján azt figyelhetjük meg, hogy a Jev sebessége ellenére rendkívül jól tartja magát, valahol a kis gpt-luna és közepes gpt-terra méretű modellek között helyezkedik el,bár a gpt-6-luna egyértelműen okosabb mint az elődje. A tesztelt Racka-Jev, pici mérete és feladattípuson való alultanítottsága miatt jelentősen gyengébb eredményt mutatott, viszont mint ahogy az ábrán látható se a naiv (mindig az általános, első vagy középső válaszokat választjuk ki), se pedig a véletlen szerű válaszadás közelében sem volt, így következtethetünk valódi intelligens döntéshozatalra.
Szemben a pontossággal a TypeSafe állításai szerint a legnagyobb előnye a Jev szerű modelleknek a sebességük. Bár a saját esetünkben több százszoros sebesség növekedést nem láttunk, a nagy nyelvi modellekhez képest átlagosan legalább 10-szer gyorsabban hozták meg ezeket a döntéseket a Jev szerű modellek, és a helyi Racka-Jev modellünk a lokalitásnak köszönhetően még az eredeti Jevet is megelőzte.
Két további hasznos adat amikről érdemes beszélni: A feladatonkénti pontosság lebontás, már most is működik. Ez azt mutatja, hogy még az alulméretezett és tanítás nélküli RackaJev is képes bizonyos feladatokat (például az embereknek szükséges információ jelzését) ellátni..
A másik érdekes adat, hogy hogyan változtat az angol vagy magyar nyelv az elért eredményeken ugyanazon feladatokban. Itt jól látható, hogy jelentős a javulás, több mint 5% változik a RackaJev esetében, ami szintén arra mutat, hogy további finomhangolás jelentős javulást eredményezne.
Érdemes azt is megemlíteni, hogy a gpt-luna modellek és a claude haiku modell a tesztelés során a kérdések közel 8-12%-ra nem is generáltak helyesen értelmezhető választ a megfelelő JSON struktúrában. Azaz ilyenkor nem a pontossága miatt volt helytelen az eredmény, hanem mert a válasz szintaktikailag helytelen volt.
Végül a konfidencia mérésünk. Sajnos a RackaJev esetén láttuk, hogy extra tanítás nélkül, nem képes a modell saját magára helyesen konfidenciát tippelni. Viszont ezt a Jev esetében megtették, ezért legyőzte az összes tesztelt nagy nyelvi modellt. Az ábrát úgy érdemes nézni, hogy mennyire jól követik a modellek az átlós vonalat.
Milyen következtetést vontunk le ebből?
Két dolgot biztosan le lehet vonni már ezekből az adatokból. Az általunk végzett irodai (specifikusan DocAudit típusú) feladatokon, a Jev, nemcsak hogy több tizenvalahányszoros sebességet kínál, de a válaszok pontosságában is versenyképes marad. Ezentúl nem képes olyan választ adni, amit nem kértünk, vagyis elkerüli azokat a hibákat is, mint amiket a pici nyelvi modellek okoztak.
A Jev használata a saját termékünkben egyértelműen hasznos lesz, akár több napnyi erőforráshasználatot képes lecsökkenteni néhány órára egy teljes projekt kezelése során. Ami külön érdekes, hogy minimális változtatással egy személyre szabott lokális modell, pláne célfeladatra előkészítve és továbbtanítva, szintén adhat megoldást erre a problémára. Ez azért is jó hír, mert így azon cégek számára, akiknek az adatbiztonság védelme érdekében az EGT-n belüli adatfeldolgozás sem elfogadható, hanem kifejezetten irodán belül kell, hogy maradjon az adat. Kaptak egy új lokális és megfelelő hardver mellett futtatható DocAudit megoldást, Jev típusú feladatokra.
Az elmélet már megvan – jöhet a megvalósítás?
Az elmélet már megvan – jöhet a megvalósítás?
Ne hagyja, hogy a mesterséges intelligencia csak egy érdekes olvasmány maradjon. Segítünk azonosítani azokat a pontokat, ahol az AI az Ön cégénél is azonnali, mérhető hatékonyságnövelést hozhat.
Ne hagyja, hogy a mesterséges intelligencia csak egy érdekes olvasmány maradjon. Segítünk azonosítani azokat a pontokat, ahol az AI az Ön cégénél is azonnali, mérhető hatékonyságnövelést hozhat.

Blog
© 2026 mynds.ai. Adatkezelési Tájékoztató
Blog
© 2026 mynds.ai. Adatkezelési Tájékoztató
