
Szakértői rovatunk
Mit jelent egy AI-benchmark? ARC-AGI, GPT-6 Astra és a modellek valódi teljesítménye
Mit jelent egy AI-benchmark? ARC-AGI, GPT-6 Astra és a modellek valódi teljesítménye

Gergő
Vörös
Amikor először megjelenik egy új AI modell, az első dolog amire mindenki kíváncsi, hogy jobb-e, mint az elődei. A feladat egyszerűnek tűnhet: adjuk fel ugyanazt a kérdéssort a modelleknek és mérjük össze melyik válaszolt jobban. A valóságban azonban már a “jobb” fogalma is egy bonyolultabb kérdéssé válik. Jobb a programozásban? Jobb kép generálásban? Vagy esetleg jobban tud magyarul?
Ezen kérdésekre segítenek választ adni a benchmark-ok. A benchmarking egy olyan folyamat, mely során standardizált tesztekkel mérjük egy modell teljesítményét egy adott feladatra. Manapság minden új modell mellé kapunk egy táblázatot vagy százalékot a modell által elért benchmark-okról. Az eredmények viszont csak akkor jelentenek tényleges áttörést, ha pontosan tudjuk értelmezni mit is mért az adott teszt.
Benchmark, az AI mérőeszköze
Ahhoz, hogy megértsük miért lehet megtévesztő egy-egy mérés, előbb meg kell értenünk hogy is működik a folyamat. Egy benchmark egy specifikus feladatkészlet és az ahhoz tartozó értékelési módszer. Az AI megkapja a feladatokat, majd egy szabályrendszer alapján pontozásra kerül a teljesítmény. Ez a teljesítmény lehet egy feladat választós helyes válasz arány, vagy akár kódolás esetében a sikeresen lefutott automatikus tesztek aránya.
Ebből már sejthető, hogy az AI modellek intelligenciájának általános meghatározása nem egy magától értetődő feladat. Nincs olyan benchmark, ami alapján kijelenthető, hogy az adott modell a legokosabb. Ugyanaz a modell eltérő képet mutathat különböző méréseken: lehet, hogy a matematikai számításokban kiemelkedik, miközben egy összetett szöveg megfogalmazásánál merőben alulmarad a többi modellel szemben.
A benchmark eredmények forrása szintén egy fontos tényező lehet. A fejlesztő cégek az új modell megjelenésekor általában saját méréseket publikálnak: ezeket nevezzük “self-report” eredménynek. Habár ezek az adatok hasznosak a teljesítmény megítéléséhez, észben kell tartani, hogy az ilyen esetekben a mérési körülményeket és feltételeket maga a modell készítője határozza meg. Független méréseknél a modelleket egy külső szervezet, egységes módon vizsgálja.
A benchmark önmagában tehát nem döntő tényező, csak egy mérőeszköz. Ahogy egy diák angol tudását sem értékelhetjük a matek dolgozatai alapján, úgy az AI-t sem ítélhetjük meg egyetlen benchmark eredményéből. A félreértések veszélye akkor áll fenn, mikor egy specifikus mérési siker után túl általános következtetéseket szeretnénk vonni.
ARC-AGI és az általános mesterséges intelligencia
Az egyik legjobb példa a félreértelmezett benchmark-okra az ARC-AGI esete. A név már önmagában nagyratörő, hiszen az AGI (Artificial General Intelligence) jelentése az általános mesterséges intelligencia, aminek bár pontos definíciója vitatott, mégis alapvetően egy hatalmas előrelépésre utal. Általában olyan AI-t értünk alatta, ami kognitív képességeiben megegyezik az emberi aggyal, vagy meghaladja azt.
Az általános mesterséges intelligencia nagyban különbözik a mai AI-rendszerektől. Igaz, hogy sok feladatban a modellek meghaladják az emberi képességeket, mégis több, számunkra egyszerűen megoldható problémán továbbra is elhasalnak. Az AGI elérése emiatt egy nehezen meghatározható cél és nem lehet egyetlen teszttel definiálni. Az ARC-AGI benchmark sorozat is csupán az alkalmazkodási készség és az absztrakt gondolkodás mérésére próbál megoldást nyújtani, ezzel az AGI legfeljebb néhány aspektusát vizsgálva.
A 2019-es megjelenésű ARC-AGI-1 színes négyzetrácsokból álló logikai feladatokkal próbálta mérni a modell adaptív képességeit: néhány korábbi példa alapján kellett felismerni a feladat működését és megfelelő kimenetet adni. Míg a teszteket ember által könnyen teljesíthetőnek tekintették, a legjobb hasonlítható AI teljesítmény 2020-ban nagyjából 20% volt. 2025-ben követte elődjét az ARC-AGI-2, ami az említett rácsalapú formátumot többlépéses, összetettebb feladatokkal nehezítette. Az ARC állítása szerint az emberek számára ezek továbbra is túlnyomó részt megoldhatóak voltak, az akkori AI teljesítmény pedig nem haladta meg az 5%-ot.
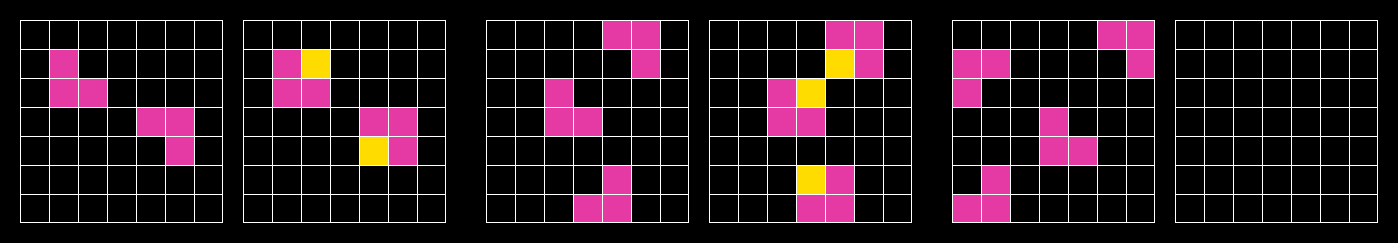
ARC-AGI-1 feladvány - Forrás: https://arcprize.org/arc-agi/1
Az igazi változást azonban az ARC-AGI-3 hozta 2026-ban, ahol már interaktív, játékszerű feladványokból álltak a tesztek. Itt a tesztalanynak (legyen az modell, vagy személy) kísérleteznie kell a környezettel, felismerni a működést és az alapján dönteni. A benchmark a felismerésen túl már a felfedezésre való képességet és a tervezést is vizsgálja. A feladványok 100%-a ember számára megoldhatónak bizonyult, miközben a márciusi megjelenések idejében a frontier AI modellek teljesítménye 1% alatt maradt.
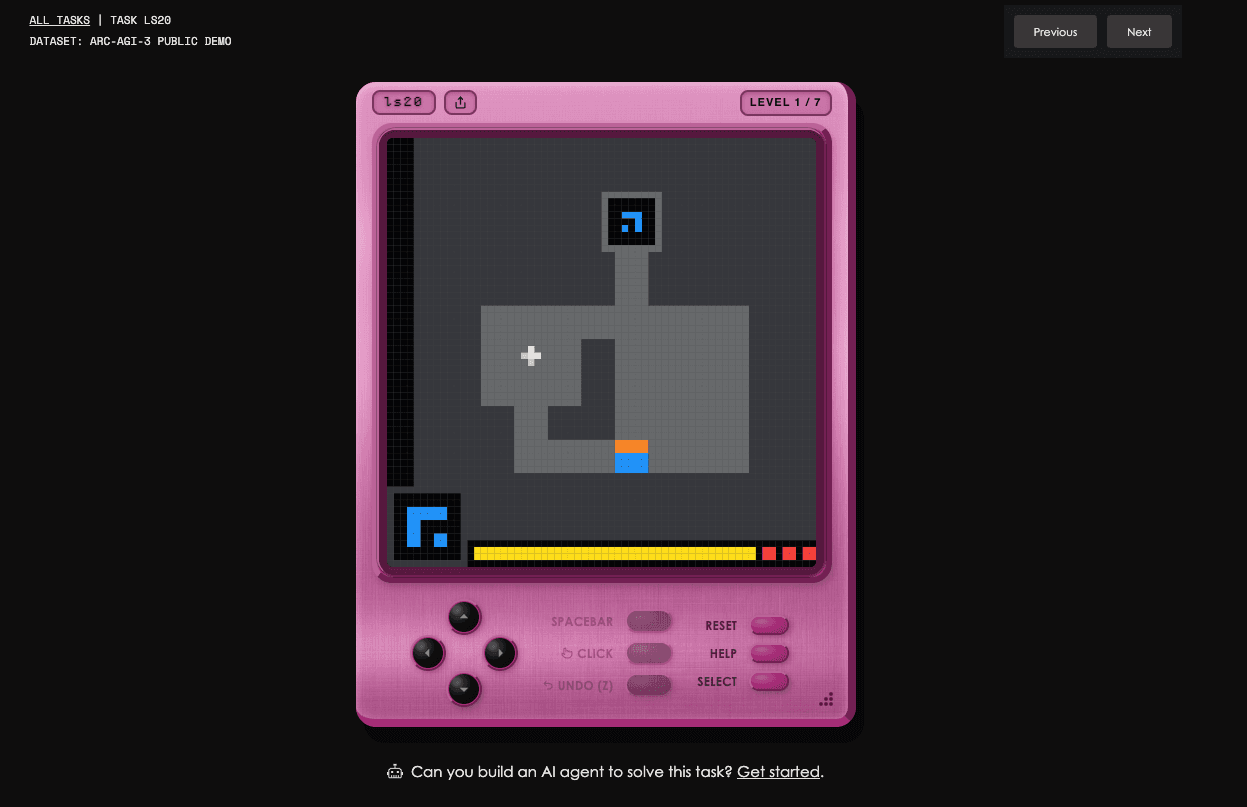
ARC-AGI-3 feladvány - Forrás: https://arcprize.org/tasks/ls20
Ez azt jelenti hogy az ARC-AGI-3 képes az általános intelligencia eldöntésére? Nem egészen. A benchmark csak egy tudatosan kialakított mérőeszköz, ami az intelligencia bizonyos tulajdonságaira helyezi a fókuszt. Nem vizsgál széleskörű tudást, természetes kommunikációt vagy reakciós készséget a való világ kiszámíthatatlanságaira.
A tényleges eredmény mindössze azt mutatja, hogy a modell hogyan teljesít az ARC által meghatározott probléma-halmazon. A magas teljesítmény utalhat arra, hogy egy lépéssel közelebb kerültünk az AGI eléréséhez, de a célvonal átlépéséhez önmagában nem elég. A névben is szereplő “AGI” fogalom súlya így jelentősebbnek tűnhet, mint amit valójában takar.
GPT-6 Astra: áttörés vagy médiafogás?
Nagy port kavart a 2026 szeptemberében debütáló GPT-6 Astra modell. Az OpenAI bejelentései az Astrát a valaha volt legintelligensebb kiadott modellként írják le, kiemelve a számítógép-használatot, böngészést, szoftverfejlesztést, kiberbiztonságot és a professzionális szaktudást igénylő területeken való képességeit.
A média (és maga az OpenAI) tekintete azonban főként az ARC-AGI-3 eredményekre szegeződött. Az ezt megelőző GPT-5.6 Sol 7.8%-ához képest az elért 99.9%-os benchmark hatalmas ugrásnak bizonyult.
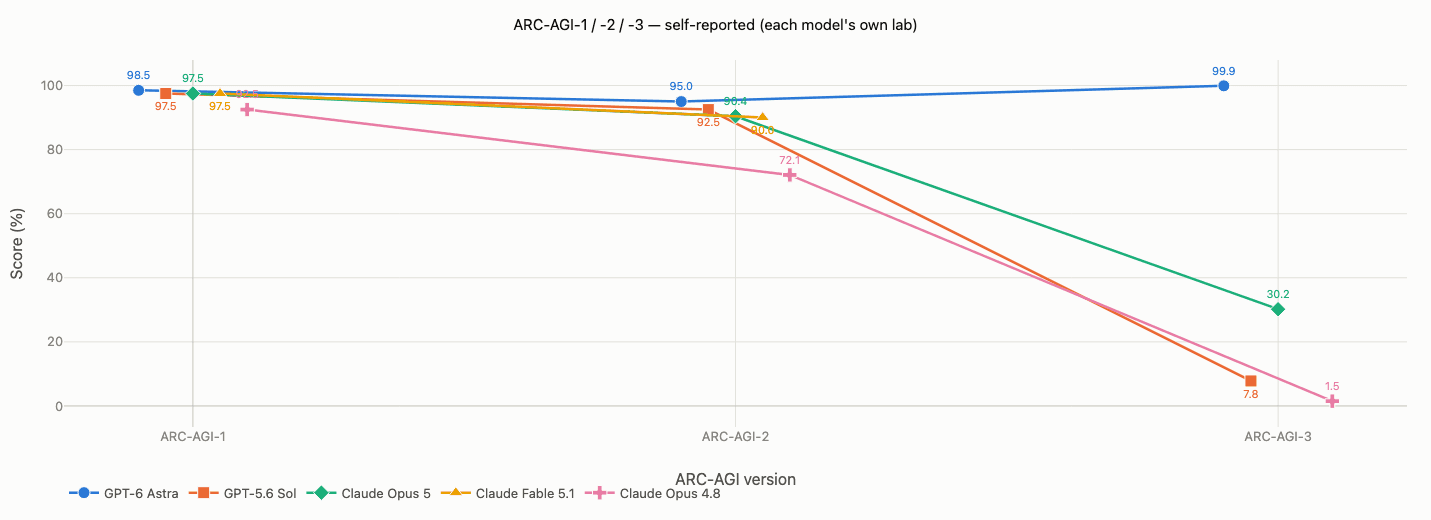
ARC-AGI eredmények verziók szerint (self-report), GPT-6 Astra vs. GPT-5.6 Sol vs. Claude Opus 5 vs. Claude Fable 5.1
Adat: https://openai.com/hu-HU/index/gpt-6-astra/ https://www-cdn.anthropic.com/c5fbac3f0b1280a933ebd26d3cb8bb9f5bdeaf48/Claude%20Opus%205%20System%20Card.pdf
Az absztrakt gondolkodásban elért sikerek és a kiemelkedő matematikai vagy számítógép-használati saját mérésű benchmark-ok a figyelem középpontjába helyezték a modellt. Sokan már arra a következtetésre jutottak, hogy az Astra már el is érte az általános mesterséges intelligenciát.
Felmerül a kérdés, hogy a GPT-6 Astra tényleg a legintelligensebb modell-e a piacon. Habár vannak, akik ezt állítják, valójában ez továbbra sem tényszerű. Az ARC-AGI benchmark-ok, programozási tesztek vagy egyéb mérések mind más-más képességeket vizsgálnak. További árnyaló tényező, hogy ezek az eredmények elsősorban self-report mérésekből születtek. Az OpenAI is kiemeli, hogy az értékeléseknél a GPT-modellek legjobb elért eredményeit közli az egyes reasoning effort beállítások közül, és hogy egyes tesztek kutatási környezetben vagy API-n keresztül futottak. Emiatt nem is lehet elvárni, hogy egy átlagos ChatGPT beszélgetés során ugyanezt tapasztaljuk.
Ahogy az már kifejtésre került, az ARC-AGI-3-ból előállt eredmény nem jelent tényleges AGI-t, ahogy válogatott benchmark eredmények sem helyeznek egy modellt a dobogó tetejére. Ettől a gyártói mérések nem válnak értéktelenné, hisz továbbra is jó rálátást adnak arra, hogy a modellek milyen területeken értek el fejlődést.
Ahhoz, hogy teljes képet kapjunk, érdemes megnézni, hogyan teljesítenek ugyanezeken a benchmark-okon más frontier modellek és hogy a gyártói eredmények mennyire vannak összhangban a független mérésekkel.
Frontier modellek és benchmark-jaik
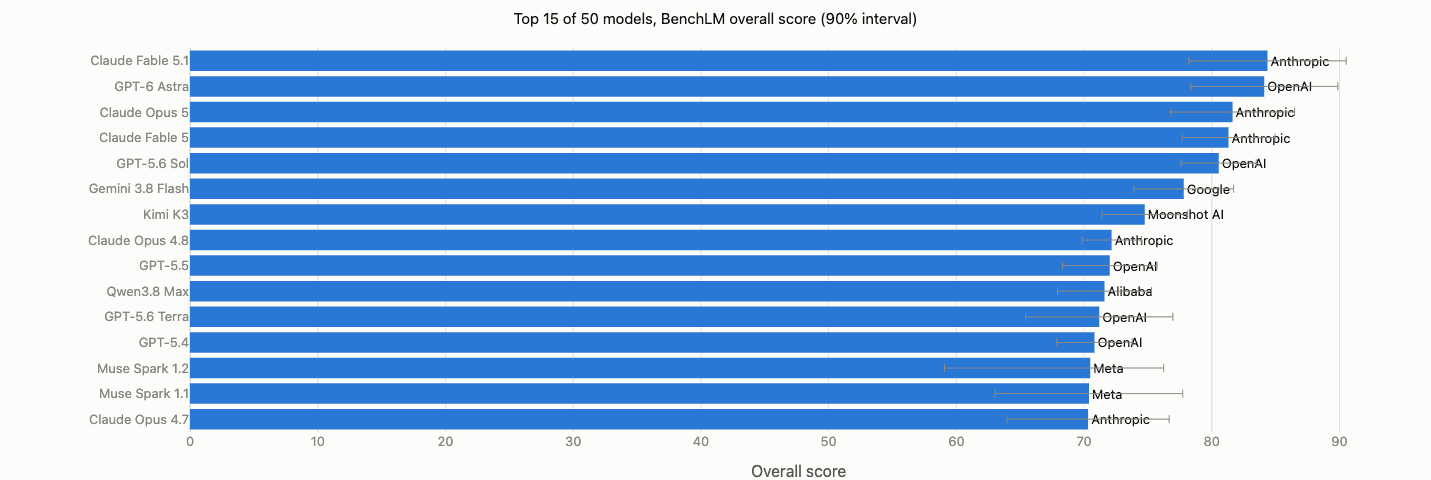
A BenchLM 50 modellt tartalmazó összesített rangsorának első 15 helyezettje.
Az Astra körüli “hype” jól mutatja miért lehet megtévesztő pár mérésből kiindulni, de a problémák akkor is fennállhatnak, ha több benchmark eredményt próbálunk egy rangsorba sűríteni. A BenchLM összesített értékelésében például 50 modellt vizsgálva a Claude Fable 5.1 84,36 ponttal került az első helyre, 0,25 ponttal megelőzve a GPT-6 Astrát (2026. szeptember 12-es adat).
Az összesített pontszám viszont elrejti, hogy valójában miben különböznek a képességek. Kategóriákra bontva láthatjuk, hogy sok más modell is versenyben van:
Vizsgált képesség | Legmagasabb eredmény az 50 modellből |
Kódolás | Claude Fable 5.1 – 84,2 |
Agentic feladatok | Claude Fable 5.1 – 80,1 |
Reasoning | GPT-6 Astra – 89,5 |
Tudás | Claude Fable 5.1 – 86,7 |
Matematika | GPT-5.6 Sol – 97,0 |
Multimodális / grounded | Kimi K3 – 89,5 |
Multilingual | Qwen3.7 Max – 100,0 |
Utasítás követés | GLM-5.1 – 93,7 |
Az egyes BenchLM képességterületek legmagasabb pontszámú modellje az 50 vizsgált modell közül.
A kategóriák különböző típusú feladatköröket képviselnek. A kódolás programozást és bug fixeket, az agentic kategória több lépéses, eszközhasználatot igénylő feladatokat, a reasoning logikai és absztrakt következtetést, a knowledge pedig tényszerű és szakmai tudást takar. A multimodális kategóriában képek, diagramok és dokumentumok értelmezése pontozódik, a multilingual a több nyelvre való általánosítást méri, míg az utasítás követés értelemszerűen azt vizsgálja, hogy a modell milyen pontosan követi a kapott utasításokat.
A “legjobb modell” kifejezés ezért önmagában kevés jelentést hordoz: az első lépés mindig a feladatkör meghatározása. De mi történik akkor, ha a feladat értékelése nem magától értetődő?
Az AI képességeit akkor a legegyszerűbb mérni, amikor a válasz helyessége egyértelműen eldönthető (pl. matematikai feladatok vagy automatikusan tesztelhető programok). A hétköznapibb tulajdonságok, mint a kreativitás, vagy a kommunikáció minősége már kevésbé számszerűsíthető.
A gép által nehezen mérhető készségek behatárolására nyújtanak lehetőséget az olyan jellegű platformok, mint az Arena AI. Itt a felhasználók maguk értékelik az AI teljesítményét, így az eredmény emberi preferenciát mutat az objektív helyesség helyett. Azonban ennek is meg vannak a kockázatai: a “sycopancy” (amikor a modell túlságosan alkalmazkodik a felhasználó véleményéhez) indokolatlanul magas pontokhoz vezethet, így a modell valódi képességeire nem derül fény.
A megítélés csak nehezebbé válik, amikor nem külső rangsort, hanem self-report eredményeket elemzünk. Ha megpróbáljuk egy táblázatba rendezni az OpenAI, Anthropic, Google, DeepSeek vagy Alibaba számait, akkor láthatjuk, hogy a cégek nem feltétlenül ugyanazokat a benchmark-okat publikálják.
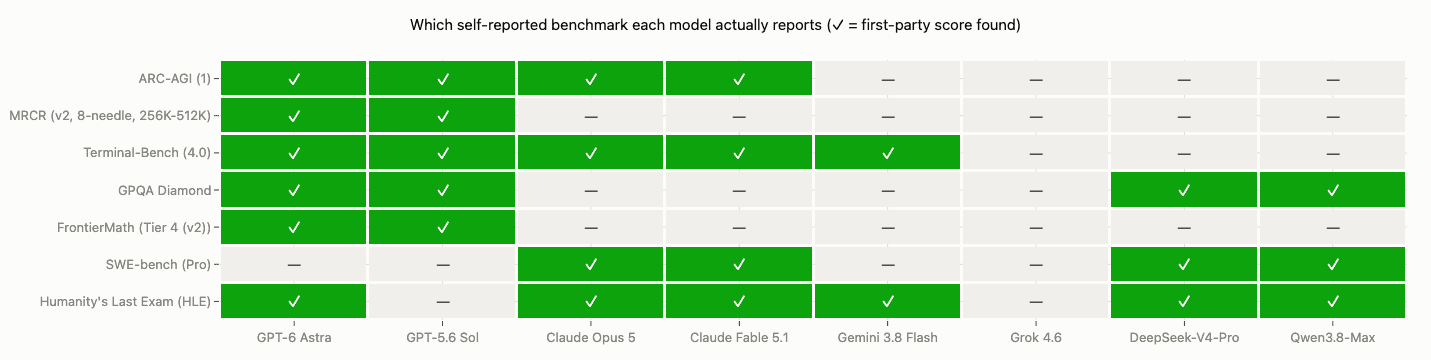
Mely benchmark-okra közöltek saját eredményt a vizsgált modellfejlesztők?
Adat: https://openai.com/index/gpt-6-astra/
https://www.anthropic.com/claude/fable
https://deepmind.google/models/gemini/flash/
https://x.ai/news/grok-4-6
https://api-docs.deepseek.com/updates/
https://www.alibabacloud.com/blog/qwen3-8-max-a-new-bar-for-coding-and-cowork_603421
Még az azonos benchmark is félrevezető lehet, hiszen nincs garantálva az azonos mérési körülmény. Eltérhet a modell reasoning beállítása, a használható eszközök köre, a teszt pontos verziója vagy akár az értékelési módszer is.
Magyar nyelvi tudás és szemmel látható különbségek
A publikált mérések bár jól összehasonlítható számokat adnak, nem feltétlenül tükrözik az élményt, amit a modell tényleges használata során tapasztalunk. Kíváncsiak voltunk, milyen eredményekkel teljesítenek a modellek magyar nyelvi környezetben, valamint összetett SVG-generálási teszteket is futtattunk.
A vizsgálatban a BenchLM összesített rangsorában a cikk írásakor 4 legjobbra értékelt modell szerepel: a Claude Fable 5.1, a GPT-6 Astra, a Claude Opus 5, valamint a GPT-5.6 Sol.
A magyar nyelvi képességek méréséhez az OpenHuEval benchmark 3 részfeladatát futtattuk. A HuSimpleQA rövid, Magyarországhoz kötődő ténykérdések, a HuWildBench pedig összetettebb, magyar kontextust igénylő kérdések megválaszolását teszteli. A HuProverbRea_OE magyar közmondások/szófordulatok értelmezését vizsgálja.
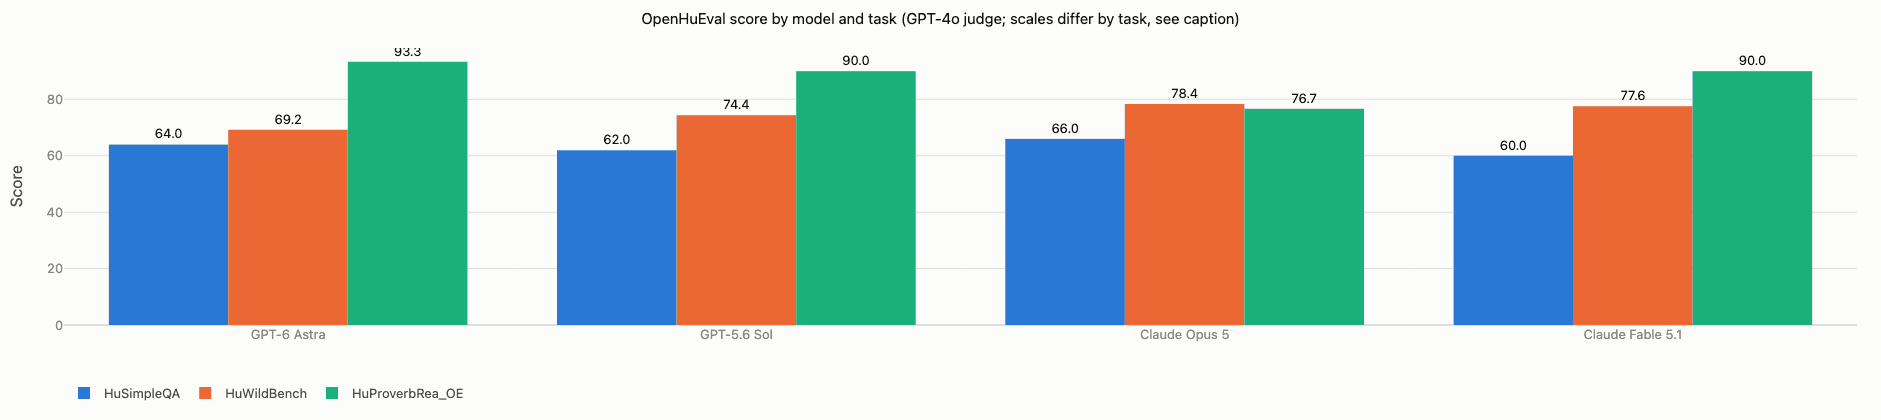
OpenHuEval eredmények - Alkalmazott judge: GPT-4o
Az eredmények alátámasztják, hogy nehéz egyértelmű következtetést levonni egy-egy benchmark alapján, még a magyar nyelvi tudás tekintetében is. A HuSimpleQA esetében a négy modell szorosan, 60 és 66 pont között teljesített. A valós felhasználói jellegű HuWildBench feladatokon nagyobb különbség alakult ki: a Claude Opus 5 78,4, az Astra pedig 69,2 pontot ért el. A magyar közmondások értelmezésénél viszont megfordult a helyzet, és az Astra 93,3%-os eredménnyel teljesített, míg az Opus 5 76,7%-ot ért el.
A számszerű benchmark-ok mellett egy látványosabb példával is szemléltetni akartuk a modellek közti különbséget. Ehhez három SVG-generálási feladatot készítettünk elő.
Az alábbi példában mind a 4 modell a következő leírást kapta meg angolul és magyarul egyaránt: “Egy búvárfelszereléses polip, amely pontosan négy izzó gyönggyel zsonglőrködik, miközben balra úszik egy elsüllyedt hajóroncs mellett; jobbra, vagyis a polip haladási irányával ellentétesen, pontosan három hal úszik, az előtérben korallzátony látható, a polip mögött pedig egy buborékcsík jelzi az útját.”
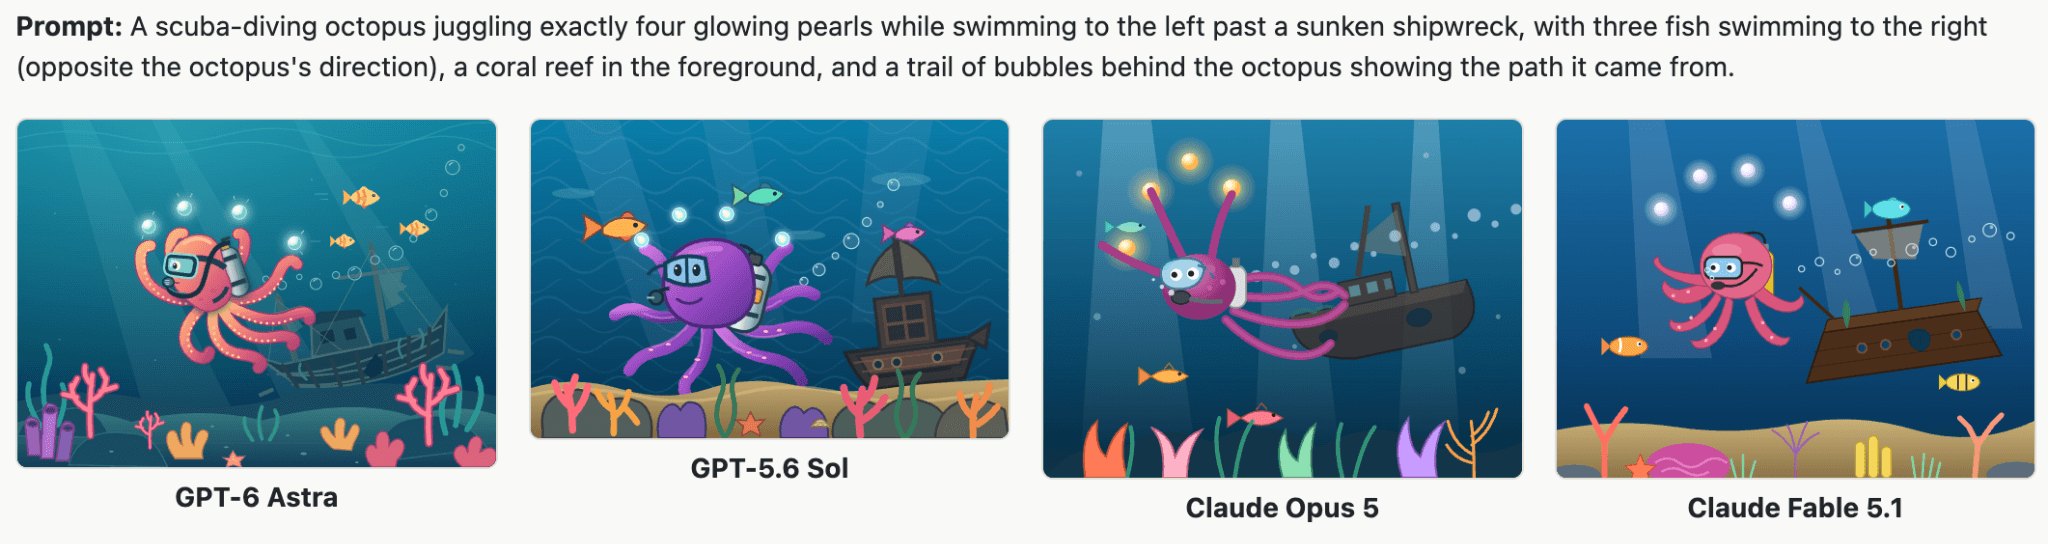
SVG-generálási teszt eredmények - angol prompt
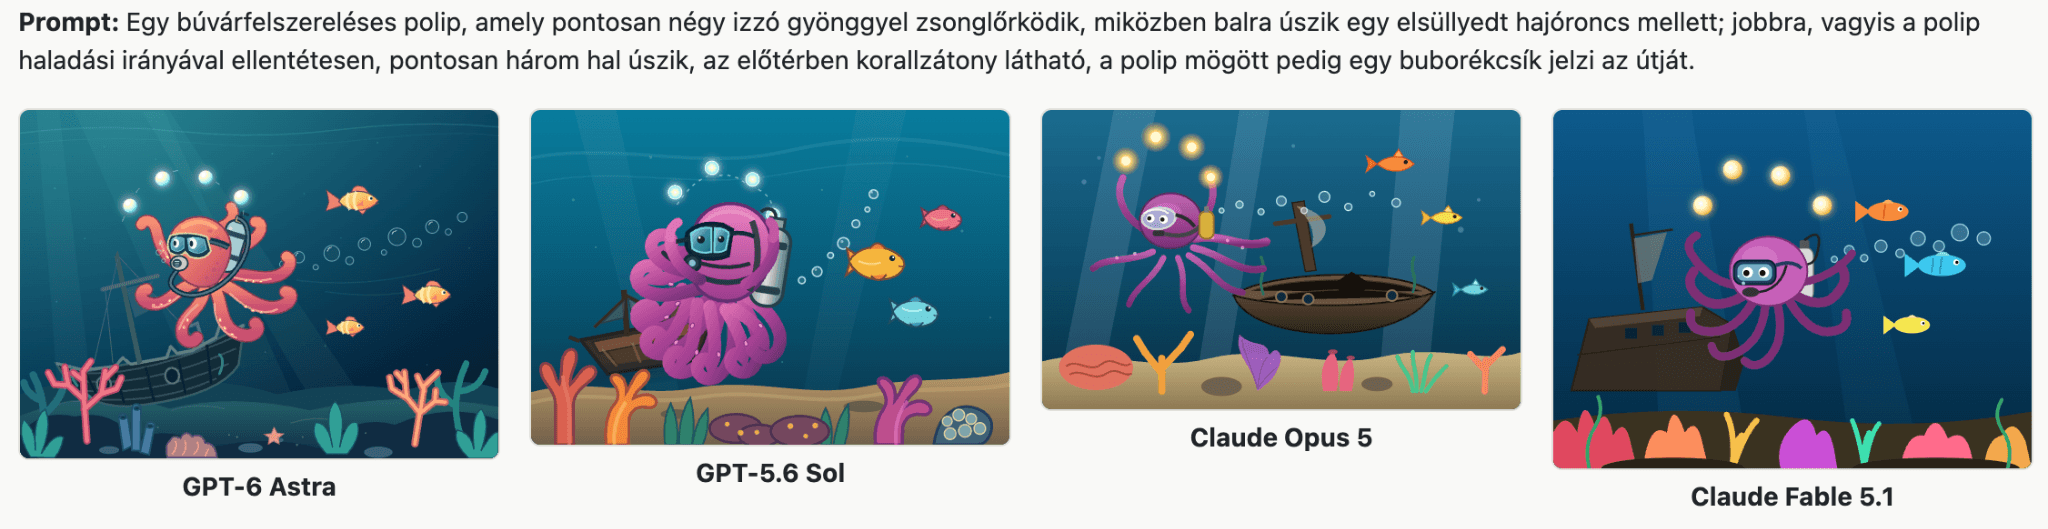
SVG-generálási teszt eredmények - magyar prompt
Ez a teszt azért tud érdekes lenni, mivel az svg (vektorgrafikus kép) egy szöveges formátumban szerkeszthető kép. Ahhoz, hogy jó minőségű svg-ket tudjon rajzolni egy modell, kiváló érvelési képességekkel kell rendelkeznie, mivel csak a szöveget látja, a képet nem.
Ezeken a képeken tényszerűen mindegyik hasonló, ugyan azok az elemek szerepel rajtuk, azonban az Astra képei annyival gazdagabbak vizuálisan, hogy minket is meglepett. Először azt hittük, hogy csalt a modell és megnézte magát a képet, viszont erre utaló jelet nem találtunk, így azt kell mondanunk, hogy ezt a kört toronymagasan nyerte az Astra. Érdemes szem előtt tartani, hogy a figyelemfelkeltő feladat ellenére, ez is csak a modellek képességeinek egy nagyon kis szeletére világít rá.
Konklúzió
A saját méréseink is azt erősítették meg, hogy egy benchmark önmagában nem ad teljes képet. A mindennapi használatban különösen igaz, hogy a frontier modellek közötti különbség jóval kisebbnek érződik, mint amit a mérési rekordok sugallnak.
Éppen ezért érdemes óvatosan kezelni az olyan kijelentéseket, hogy egy új modell „a legintelligensebb”, „emberfeletti” vagy akár már elérte az AGI-t. A média természetéből adódóan gyakran a leghangzatosabb százalék, rekord vagy összehasonlítás kerül a címbe, miközben a tényleges jelentés háttérbe szorul.
Cégünk tapasztalatai is azt mutatják, hogy nem érdemes minden munkát egy “legjobb” modellre hagyni. Csapatunk például magyar nyelvű feladatokra jellemzően a GPT-modelleket preferálja, míg kódolásnál a Claude modellek váltak be jobban. Különböző irodai feladatokra pedig, amire általában az ügyfeleinknek szüksége van (pl.: tudásbázis, dokumentum összehasonlítás, információ kinyerés), bőven elegendőek a kisebb, olcsóbb modellek, amik elég jó minőségben tudnak nagy mennyiségű feladatot, viselhető áron elvégezni.
Fontos tapasztalatunk még a szakmán belül, hogy ezek a nagy modellek igen hasznosak abban az esetben, ha valamit gyorsan kicsiben szeretnénk megoldani. Amikor viszont egy olyan eszközre van szükségünk, amin évi több tíz-, akár százezer dokumentumot át kell futtatni, akkor elengedhetetlenné válik, hogy optimalizáljunk és egy olyan cél eszközt készítsünk, ahol egy kisebb modell csak a megadott feladatot végzi el. Ilyenkor azt már ne a modellnek kelljen kitalálni, hogy pontosan mi az elvégzendő feladat.
Végső soron szerintünk a legjobb AI keresése helyett inkább azt a kérdést érdemes feltenni, hogy melyik modell, milyen feladatban és milyen körülmények között teljesít a legjobban. Ehhez pedig tökéletes támpontként szolgálnak a benchmarkok.
Amikor először megjelenik egy új AI modell, az első dolog amire mindenki kíváncsi, hogy jobb-e, mint az elődei. A feladat egyszerűnek tűnhet: adjuk fel ugyanazt a kérdéssort a modelleknek és mérjük össze melyik válaszolt jobban. A valóságban azonban már a “jobb” fogalma is egy bonyolultabb kérdéssé válik. Jobb a programozásban? Jobb kép generálásban? Vagy esetleg jobban tud magyarul?
Ezen kérdésekre segítenek választ adni a benchmark-ok. A benchmarking egy olyan folyamat, mely során standardizált tesztekkel mérjük egy modell teljesítményét egy adott feladatra. Manapság minden új modell mellé kapunk egy táblázatot vagy százalékot a modell által elért benchmark-okról. Az eredmények viszont csak akkor jelentenek tényleges áttörést, ha pontosan tudjuk értelmezni mit is mért az adott teszt.
Benchmark, az AI mérőeszköze
Ahhoz, hogy megértsük miért lehet megtévesztő egy-egy mérés, előbb meg kell értenünk hogy is működik a folyamat. Egy benchmark egy specifikus feladatkészlet és az ahhoz tartozó értékelési módszer. Az AI megkapja a feladatokat, majd egy szabályrendszer alapján pontozásra kerül a teljesítmény. Ez a teljesítmény lehet egy feladat választós helyes válasz arány, vagy akár kódolás esetében a sikeresen lefutott automatikus tesztek aránya.
Ebből már sejthető, hogy az AI modellek intelligenciájának általános meghatározása nem egy magától értetődő feladat. Nincs olyan benchmark, ami alapján kijelenthető, hogy az adott modell a legokosabb. Ugyanaz a modell eltérő képet mutathat különböző méréseken: lehet, hogy a matematikai számításokban kiemelkedik, miközben egy összetett szöveg megfogalmazásánál merőben alulmarad a többi modellel szemben.
A benchmark eredmények forrása szintén egy fontos tényező lehet. A fejlesztő cégek az új modell megjelenésekor általában saját méréseket publikálnak: ezeket nevezzük “self-report” eredménynek. Habár ezek az adatok hasznosak a teljesítmény megítéléséhez, észben kell tartani, hogy az ilyen esetekben a mérési körülményeket és feltételeket maga a modell készítője határozza meg. Független méréseknél a modelleket egy külső szervezet, egységes módon vizsgálja.
A benchmark önmagában tehát nem döntő tényező, csak egy mérőeszköz. Ahogy egy diák angol tudását sem értékelhetjük a matek dolgozatai alapján, úgy az AI-t sem ítélhetjük meg egyetlen benchmark eredményéből. A félreértések veszélye akkor áll fenn, mikor egy specifikus mérési siker után túl általános következtetéseket szeretnénk vonni.
ARC-AGI és az általános mesterséges intelligencia
Az egyik legjobb példa a félreértelmezett benchmark-okra az ARC-AGI esete. A név már önmagában nagyratörő, hiszen az AGI (Artificial General Intelligence) jelentése az általános mesterséges intelligencia, aminek bár pontos definíciója vitatott, mégis alapvetően egy hatalmas előrelépésre utal. Általában olyan AI-t értünk alatta, ami kognitív képességeiben megegyezik az emberi aggyal, vagy meghaladja azt.
Az általános mesterséges intelligencia nagyban különbözik a mai AI-rendszerektől. Igaz, hogy sok feladatban a modellek meghaladják az emberi képességeket, mégis több, számunkra egyszerűen megoldható problémán továbbra is elhasalnak. Az AGI elérése emiatt egy nehezen meghatározható cél és nem lehet egyetlen teszttel definiálni. Az ARC-AGI benchmark sorozat is csupán az alkalmazkodási készség és az absztrakt gondolkodás mérésére próbál megoldást nyújtani, ezzel az AGI legfeljebb néhány aspektusát vizsgálva.
A 2019-es megjelenésű ARC-AGI-1 színes négyzetrácsokból álló logikai feladatokkal próbálta mérni a modell adaptív képességeit: néhány korábbi példa alapján kellett felismerni a feladat működését és megfelelő kimenetet adni. Míg a teszteket ember által könnyen teljesíthetőnek tekintették, a legjobb hasonlítható AI teljesítmény 2020-ban nagyjából 20% volt. 2025-ben követte elődjét az ARC-AGI-2, ami az említett rácsalapú formátumot többlépéses, összetettebb feladatokkal nehezítette. Az ARC állítása szerint az emberek számára ezek továbbra is túlnyomó részt megoldhatóak voltak, az akkori AI teljesítmény pedig nem haladta meg az 5%-ot.
ARC-AGI-1 feladvány - Forrás: https://arcprize.org/arc-agi/1
Az igazi változást azonban az ARC-AGI-3 hozta 2026-ban, ahol már interaktív, játékszerű feladványokból álltak a tesztek. Itt a tesztalanynak (legyen az modell, vagy személy) kísérleteznie kell a környezettel, felismerni a működést és az alapján dönteni. A benchmark a felismerésen túl már a felfedezésre való képességet és a tervezést is vizsgálja. A feladványok 100%-a ember számára megoldhatónak bizonyult, miközben a márciusi megjelenések idejében a frontier AI modellek teljesítménye 1% alatt maradt.
ARC-AGI-3 feladvány - Forrás: https://arcprize.org/tasks/ls20
Ez azt jelenti hogy az ARC-AGI-3 képes az általános intelligencia eldöntésére? Nem egészen. A benchmark csak egy tudatosan kialakított mérőeszköz, ami az intelligencia bizonyos tulajdonságaira helyezi a fókuszt. Nem vizsgál széleskörű tudást, természetes kommunikációt vagy reakciós készséget a való világ kiszámíthatatlanságaira.
A tényleges eredmény mindössze azt mutatja, hogy a modell hogyan teljesít az ARC által meghatározott probléma-halmazon. A magas teljesítmény utalhat arra, hogy egy lépéssel közelebb kerültünk az AGI eléréséhez, de a célvonal átlépéséhez önmagában nem elég. A névben is szereplő “AGI” fogalom súlya így jelentősebbnek tűnhet, mint amit valójában takar.
GPT-6 Astra: áttörés vagy médiafogás?
Nagy port kavart a 2026 szeptemberében debütáló GPT-6 Astra modell. Az OpenAI bejelentései az Astrát a valaha volt legintelligensebb kiadott modellként írják le, kiemelve a számítógép-használatot, böngészést, szoftverfejlesztést, kiberbiztonságot és a professzionális szaktudást igénylő területeken való képességeit.
A média (és maga az OpenAI) tekintete azonban főként az ARC-AGI-3 eredményekre szegeződött. Az ezt megelőző GPT-5.6 Sol 7.8%-ához képest az elért 99.9%-os benchmark hatalmas ugrásnak bizonyult.
ARC-AGI eredmények verziók szerint (self-report), GPT-6 Astra vs. GPT-5.6 Sol vs. Claude Opus 5 vs. Claude Fable 5.1
Adat: https://openai.com/hu-HU/index/gpt-6-astra/ https://www-cdn.anthropic.com/c5fbac3f0b1280a933ebd26d3cb8bb9f5bdeaf48/Claude%20Opus%205%20System%20Card.pdf
Az absztrakt gondolkodásban elért sikerek és a kiemelkedő matematikai vagy számítógép-használati saját mérésű benchmark-ok a figyelem középpontjába helyezték a modellt. Sokan már arra a következtetésre jutottak, hogy az Astra már el is érte az általános mesterséges intelligenciát.
Felmerül a kérdés, hogy a GPT-6 Astra tényleg a legintelligensebb modell-e a piacon. Habár vannak, akik ezt állítják, valójában ez továbbra sem tényszerű. Az ARC-AGI benchmark-ok, programozási tesztek vagy egyéb mérések mind más-más képességeket vizsgálnak. További árnyaló tényező, hogy ezek az eredmények elsősorban self-report mérésekből születtek. Az OpenAI is kiemeli, hogy az értékeléseknél a GPT-modellek legjobb elért eredményeit közli az egyes reasoning effort beállítások közül, és hogy egyes tesztek kutatási környezetben vagy API-n keresztül futottak. Emiatt nem is lehet elvárni, hogy egy átlagos ChatGPT beszélgetés során ugyanezt tapasztaljuk.
Ahogy az már kifejtésre került, az ARC-AGI-3-ból előállt eredmény nem jelent tényleges AGI-t, ahogy válogatott benchmark eredmények sem helyeznek egy modellt a dobogó tetejére. Ettől a gyártói mérések nem válnak értéktelenné, hisz továbbra is jó rálátást adnak arra, hogy a modellek milyen területeken értek el fejlődést.
Ahhoz, hogy teljes képet kapjunk, érdemes megnézni, hogyan teljesítenek ugyanezeken a benchmark-okon más frontier modellek és hogy a gyártói eredmények mennyire vannak összhangban a független mérésekkel.
Frontier modellek és benchmark-jaik
A BenchLM 50 modellt tartalmazó összesített rangsorának első 15 helyezettje.
Az Astra körüli “hype” jól mutatja miért lehet megtévesztő pár mérésből kiindulni, de a problémák akkor is fennállhatnak, ha több benchmark eredményt próbálunk egy rangsorba sűríteni. A BenchLM összesített értékelésében például 50 modellt vizsgálva a Claude Fable 5.1 84,36 ponttal került az első helyre, 0,25 ponttal megelőzve a GPT-6 Astrát (2026. szeptember 12-es adat).
Az összesített pontszám viszont elrejti, hogy valójában miben különböznek a képességek. Kategóriákra bontva láthatjuk, hogy sok más modell is versenyben van:
Vizsgált képesség | Legmagasabb eredmény az 50 modellből |
Kódolás | Claude Fable 5.1 – 84,2 |
Agentic feladatok | Claude Fable 5.1 – 80,1 |
Reasoning | GPT-6 Astra – 89,5 |
Tudás | Claude Fable 5.1 – 86,7 |
Matematika | GPT-5.6 Sol – 97,0 |
Multimodális / grounded | Kimi K3 – 89,5 |
Multilingual | Qwen3.7 Max – 100,0 |
Utasítás követés | GLM-5.1 – 93,7 |
Az egyes BenchLM képességterületek legmagasabb pontszámú modellje az 50 vizsgált modell közül.
A kategóriák különböző típusú feladatköröket képviselnek. A kódolás programozást és bug fixeket, az agentic kategória több lépéses, eszközhasználatot igénylő feladatokat, a reasoning logikai és absztrakt következtetést, a knowledge pedig tényszerű és szakmai tudást takar. A multimodális kategóriában képek, diagramok és dokumentumok értelmezése pontozódik, a multilingual a több nyelvre való általánosítást méri, míg az utasítás követés értelemszerűen azt vizsgálja, hogy a modell milyen pontosan követi a kapott utasításokat.
A “legjobb modell” kifejezés ezért önmagában kevés jelentést hordoz: az első lépés mindig a feladatkör meghatározása. De mi történik akkor, ha a feladat értékelése nem magától értetődő?
Az AI képességeit akkor a legegyszerűbb mérni, amikor a válasz helyessége egyértelműen eldönthető (pl. matematikai feladatok vagy automatikusan tesztelhető programok). A hétköznapibb tulajdonságok, mint a kreativitás, vagy a kommunikáció minősége már kevésbé számszerűsíthető.
A gép által nehezen mérhető készségek behatárolására nyújtanak lehetőséget az olyan jellegű platformok, mint az Arena AI. Itt a felhasználók maguk értékelik az AI teljesítményét, így az eredmény emberi preferenciát mutat az objektív helyesség helyett. Azonban ennek is meg vannak a kockázatai: a “sycopancy” (amikor a modell túlságosan alkalmazkodik a felhasználó véleményéhez) indokolatlanul magas pontokhoz vezethet, így a modell valódi képességeire nem derül fény.
A megítélés csak nehezebbé válik, amikor nem külső rangsort, hanem self-report eredményeket elemzünk. Ha megpróbáljuk egy táblázatba rendezni az OpenAI, Anthropic, Google, DeepSeek vagy Alibaba számait, akkor láthatjuk, hogy a cégek nem feltétlenül ugyanazokat a benchmark-okat publikálják.
Mely benchmark-okra közöltek saját eredményt a vizsgált modellfejlesztők?
Adat: https://openai.com/index/gpt-6-astra/
https://www.anthropic.com/claude/fable
https://deepmind.google/models/gemini/flash/
https://x.ai/news/grok-4-6
https://api-docs.deepseek.com/updates/
https://www.alibabacloud.com/blog/qwen3-8-max-a-new-bar-for-coding-and-cowork_603421
Még az azonos benchmark is félrevezető lehet, hiszen nincs garantálva az azonos mérési körülmény. Eltérhet a modell reasoning beállítása, a használható eszközök köre, a teszt pontos verziója vagy akár az értékelési módszer is.
Magyar nyelvi tudás és szemmel látható különbségek
A publikált mérések bár jól összehasonlítható számokat adnak, nem feltétlenül tükrözik az élményt, amit a modell tényleges használata során tapasztalunk. Kíváncsiak voltunk, milyen eredményekkel teljesítenek a modellek magyar nyelvi környezetben, valamint összetett SVG-generálási teszteket is futtattunk.
A vizsgálatban a BenchLM összesített rangsorában a cikk írásakor 4 legjobbra értékelt modell szerepel: a Claude Fable 5.1, a GPT-6 Astra, a Claude Opus 5, valamint a GPT-5.6 Sol.
A magyar nyelvi képességek méréséhez az OpenHuEval benchmark 3 részfeladatát futtattuk. A HuSimpleQA rövid, Magyarországhoz kötődő ténykérdések, a HuWildBench pedig összetettebb, magyar kontextust igénylő kérdések megválaszolását teszteli. A HuProverbRea_OE magyar közmondások/szófordulatok értelmezését vizsgálja.
OpenHuEval eredmények - Alkalmazott judge: GPT-4o
Az eredmények alátámasztják, hogy nehéz egyértelmű következtetést levonni egy-egy benchmark alapján, még a magyar nyelvi tudás tekintetében is. A HuSimpleQA esetében a négy modell szorosan, 60 és 66 pont között teljesített. A valós felhasználói jellegű HuWildBench feladatokon nagyobb különbség alakult ki: a Claude Opus 5 78,4, az Astra pedig 69,2 pontot ért el. A magyar közmondások értelmezésénél viszont megfordult a helyzet, és az Astra 93,3%-os eredménnyel teljesített, míg az Opus 5 76,7%-ot ért el.
A számszerű benchmark-ok mellett egy látványosabb példával is szemléltetni akartuk a modellek közti különbséget. Ehhez három SVG-generálási feladatot készítettünk elő.
Az alábbi példában mind a 4 modell a következő leírást kapta meg angolul és magyarul egyaránt: “Egy búvárfelszereléses polip, amely pontosan négy izzó gyönggyel zsonglőrködik, miközben balra úszik egy elsüllyedt hajóroncs mellett; jobbra, vagyis a polip haladási irányával ellentétesen, pontosan három hal úszik, az előtérben korallzátony látható, a polip mögött pedig egy buborékcsík jelzi az útját.”
SVG-generálási teszt eredmények - angol prompt
SVG-generálási teszt eredmények - magyar prompt
Ez a teszt azért tud érdekes lenni, mivel az svg (vektorgrafikus kép) egy szöveges formátumban szerkeszthető kép. Ahhoz, hogy jó minőségű svg-ket tudjon rajzolni egy modell, kiváló érvelési képességekkel kell rendelkeznie, mivel csak a szöveget látja, a képet nem.
Ezeken a képeken tényszerűen mindegyik hasonló, ugyan azok az elemek szerepel rajtuk, azonban az Astra képei annyival gazdagabbak vizuálisan, hogy minket is meglepett. Először azt hittük, hogy csalt a modell és megnézte magát a képet, viszont erre utaló jelet nem találtunk, így azt kell mondanunk, hogy ezt a kört toronymagasan nyerte az Astra. Érdemes szem előtt tartani, hogy a figyelemfelkeltő feladat ellenére, ez is csak a modellek képességeinek egy nagyon kis szeletére világít rá.
Konklúzió
A saját méréseink is azt erősítették meg, hogy egy benchmark önmagában nem ad teljes képet. A mindennapi használatban különösen igaz, hogy a frontier modellek közötti különbség jóval kisebbnek érződik, mint amit a mérési rekordok sugallnak.
Éppen ezért érdemes óvatosan kezelni az olyan kijelentéseket, hogy egy új modell „a legintelligensebb”, „emberfeletti” vagy akár már elérte az AGI-t. A média természetéből adódóan gyakran a leghangzatosabb százalék, rekord vagy összehasonlítás kerül a címbe, miközben a tényleges jelentés háttérbe szorul.
Cégünk tapasztalatai is azt mutatják, hogy nem érdemes minden munkát egy “legjobb” modellre hagyni. Csapatunk például magyar nyelvű feladatokra jellemzően a GPT-modelleket preferálja, míg kódolásnál a Claude modellek váltak be jobban. Különböző irodai feladatokra pedig, amire általában az ügyfeleinknek szüksége van (pl.: tudásbázis, dokumentum összehasonlítás, információ kinyerés), bőven elegendőek a kisebb, olcsóbb modellek, amik elég jó minőségben tudnak nagy mennyiségű feladatot, viselhető áron elvégezni.
Fontos tapasztalatunk még a szakmán belül, hogy ezek a nagy modellek igen hasznosak abban az esetben, ha valamit gyorsan kicsiben szeretnénk megoldani. Amikor viszont egy olyan eszközre van szükségünk, amin évi több tíz-, akár százezer dokumentumot át kell futtatni, akkor elengedhetetlenné válik, hogy optimalizáljunk és egy olyan cél eszközt készítsünk, ahol egy kisebb modell csak a megadott feladatot végzi el. Ilyenkor azt már ne a modellnek kelljen kitalálni, hogy pontosan mi az elvégzendő feladat.
Végső soron szerintünk a legjobb AI keresése helyett inkább azt a kérdést érdemes feltenni, hogy melyik modell, milyen feladatban és milyen körülmények között teljesít a legjobban. Ehhez pedig tökéletes támpontként szolgálnak a benchmarkok.
Az elmélet már megvan – jöhet a megvalósítás?
Az elmélet már megvan – jöhet a megvalósítás?
Ne hagyja, hogy a mesterséges intelligencia csak egy érdekes olvasmány maradjon. Segítünk azonosítani azokat a pontokat, ahol az AI az Ön cégénél is azonnali, mérhető hatékonyságnövelést hozhat.
Ne hagyja, hogy a mesterséges intelligencia csak egy érdekes olvasmány maradjon. Segítünk azonosítani azokat a pontokat, ahol az AI az Ön cégénél is azonnali, mérhető hatékonyságnövelést hozhat.

Blog
© 2026 mynds.ai. Adatkezelési Tájékoztató
Blog
© 2026 mynds.ai. Adatkezelési Tájékoztató
