
Hibrid, gráfalapú és tanított ágensalapú RAG-módszereket mértünk valós dokumentumokon, dokumentumellenőrzési (audit) célokra. A mérések tanulsága az, hogy a legegyszerűbb, de nem triviális megoldás meglepően nehezen verhető.
Képzeld el, hogy egy közbeszerzési ajánlatot kell ellenőrizned a felhívás követelményei szerint. Teljesít minden kötelező feltételt? Szerepel benne minden előírt kikötés? Ilyen kérdéslistákat (checklisteket) a cégek nap mint nap töltenek ki hosszú, vegyes dokumentumgyűjtemények alapján. Kézzel ez lassú és drága, ezért az automatizálás komoly értéket jelentene.
A természetes nyelvfeldolgozás (NLP) és a generatív mesterséges intelligencia (GenAI) fejlődésével a nagy nyelvi modellek (LLM) és az MI-ügynökök (AI agent) erre a legkézenfekvőbb megoldásnak tűnhetnek. A bökkenő viszont az, hogy az automatizálás minősége a visszakeresésen múlik. A visszakereséssel kiegészített generálás (RAG) két lépésben dolgozik: először megkeresi a releváns szövegrészeket, aztán ezekből válaszol a modell. Ha a bizonyíték nem kerül be a kontextusablakba, a rendszer vagy hallucinál, vagy nem válaszol. A kérdéslista (checklist) kitöltése tehát elsősorban keresési probléma.
Ezért megmértük, hogyan teljesítenek a legnépszerűbb RAG-megközelítések valódi dokumentumokon.
A probléma: a RAG-et nem valódi dokumentumokon mérik
A visszakeresési technikák három nagy családja mind a saját irodalmában számít csúcstechnikának. A hibrid keresés a lexikai (kulcsszavas) és a szemantikus (jelentésbeli) egyezést kombinálja. A gráfalapú keresés (Graph RAG) a dokumentumokból épített tudásgráfot használja. A többlépéses, ágensalapú keresés, amit a Claude vagy a ChatGPT is végez, pedig egymásra épülő keresési lépéseket hajt végre.
Ezeket a módszereket azonban többnyire Wikipédia-stílusú kérdés-válasz adatkészleteken értékelik, ahol a szövegrészletek rövidek és tiszták, az entitásnevek (például a szerződő cég neve) pedig egyértelműek. A valódi dokumentumok mások: hosszúak, számozott cikkelyekből és mellékletekből állnak, tele vannak kereszthivatkozásokkal ("lásd a 2.2.6 pontot"), bonyolult táblázatokat tartalmaznak, és egy kérdés megválaszolásához gyakran több dokumentumból kell információt összeszedni.
A szerződésekre és pénzügyi beszámolókra készült benchmarkok többnyire egyetlen dokumentum megértését mérik. Azt nem, hogy egy keresési architektúra mit kezd egy összetartozó dokumentumcsomaggal. Jelenleg nem létezik olyan benchmark, ahol valós, munkához felhasznált dokumentumokon, és reális adat mennyiségen mérték ki a tesztelt megoldások teljesítményét, ezért fontosnak tartottuk, hogy egy valós képet kapjunk a megoldások minőségéről, valós keretek között.
Az adatkészlet: valódi uniós dokumentumok, szintetikus kérdések
Olyan benchmarkot akartunk, amely közel áll az éles használathoz, ezért a közbeszerzés mellett döntöttünk. Egy pályázat természetes checklist-alapanyag: összekapcsolódó dokumentumokból áll (felhívás, adminisztratív és műszaki specifikáció, keretszerződés-tervezet, mellékletek), és egyetlen kérdéshez gyakran több dokumentumot kell összevetni.
Az Európai Bizottság Funding & Tenders portáljáról hét nyilvános pályázatot töltöttünk le a teljes dokumentációjukkal együtt. Ez 62 PDF-et és nagyjából ezer oldalt jelent, az iskolai kirándulásoktól a tengerbiztonsági felszereléseken át az uniós kiberbiztonságig. A rendszer egyszerre egy pályázatot dolgoz fel, ahogy egy valódi ellenőrzés is, így a keresés mindig csak az adott pályázat dokumentumain fut.
A hozzájuk tartozó 97 kérdést és referenciaválaszt szintetikus adatgeneráló folyamat készítette. A feldolgozó folyamat (pipeline) kinyeri a szöveget, tokenekből (szavakból vagy szó-részletekből) álló darabokra (chunkokra) bontja, majd egy LLM először jelölt kérdéseket gyűjt, végül kérdéstípusonként összeállítja a végleges kérdéseket a hozzájuk tartozó bizonyítékrészletekkel.
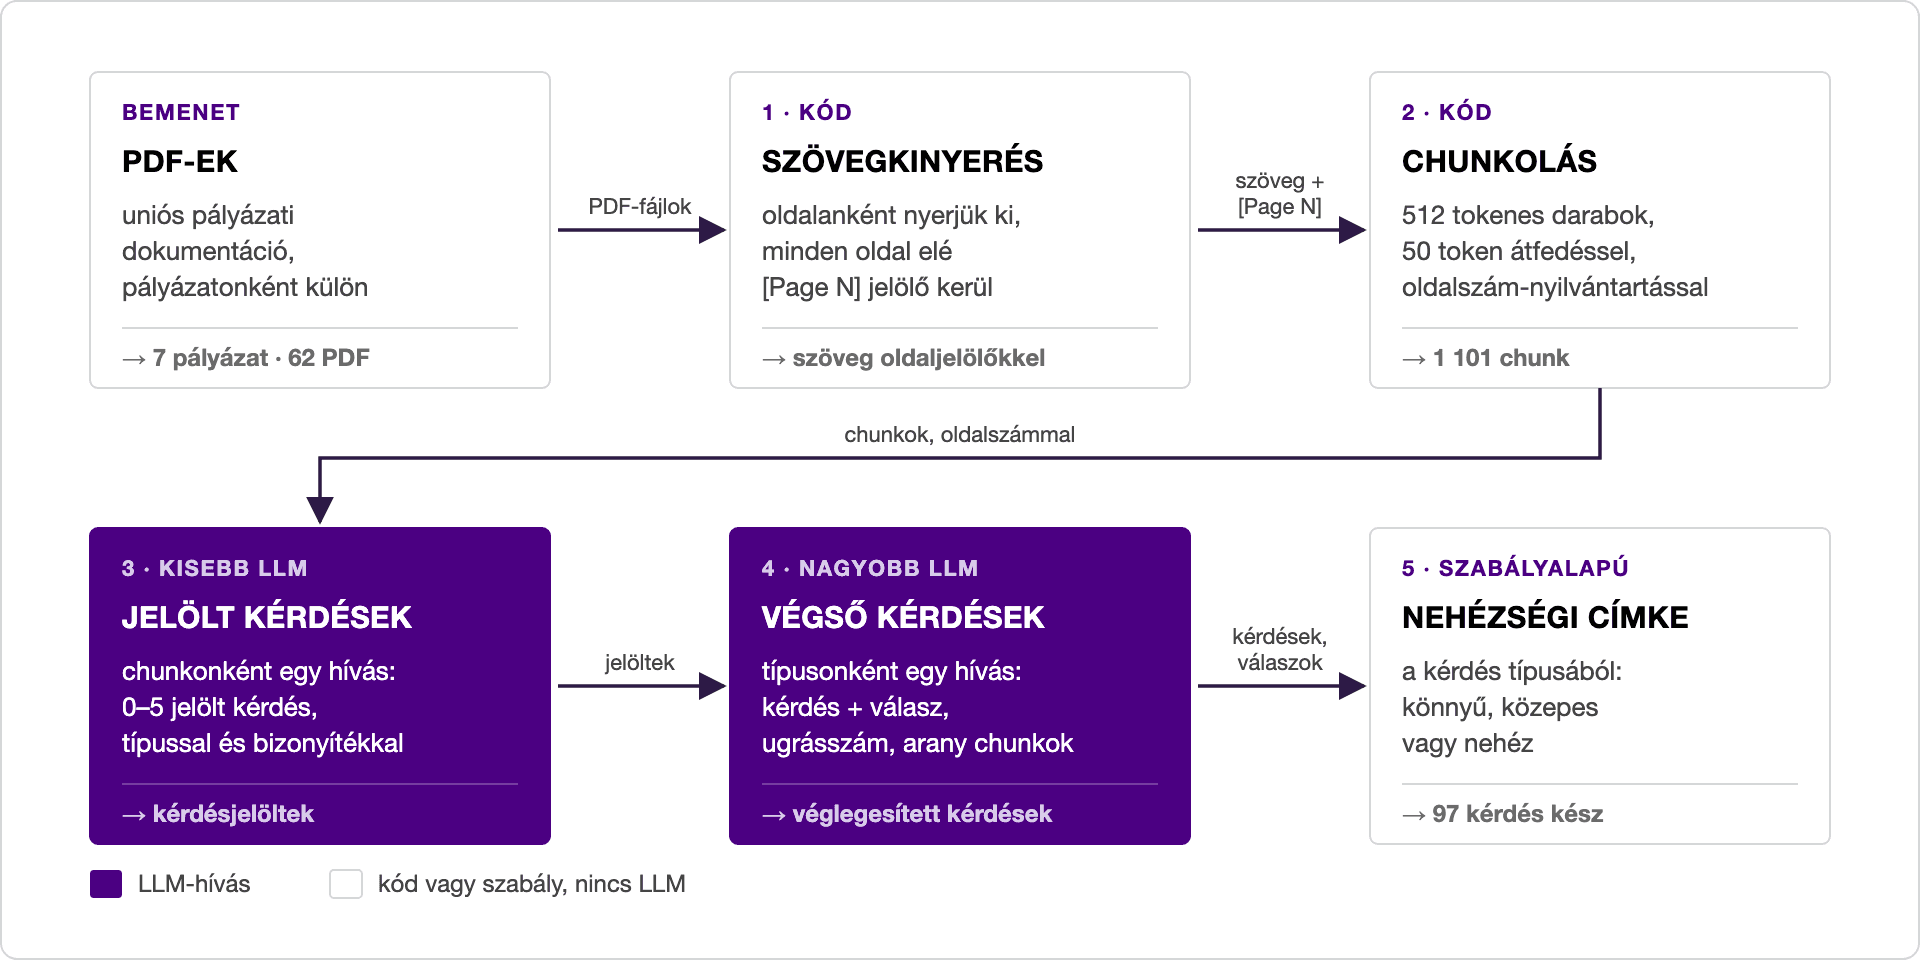
A kérdéseket öt típusba soroltuk, mert a keresésnek nem minden kérdés jelent azonos feladatot:
Egydokumentumos keresés (könnyű): a válasz egyetlen helyen van.
Egydokumentumos következtetés (közepes): több tényt kell összekapcsolni, de egy dokumentumon belül.
Dokumentumok közötti ténykérdés (közepes): az információ több dokumentumban van szétszórva.
Implicit többugrásos kérdés (nehéz): egy kereszthivatkozást követve lehet eljutni a válaszhoz, egyetlen szövegrészlet sem tartalmazza a teljes választ.
Megválaszolhatatlan kérdés (nehéz): hihetően hangzik, de a dokumentumokban nincs rá válasz. A jó rendszernek ezt is meg kell mondania. Egy példa a negyedik típusra: "A dokumentum szerint a projekt és az ár a 'Tervezés és határidők' szakasz szerint kerül egyeztetésre. Ha egy késedelem eltolja a mérföldköveket, mit jelent ez az ár véglegesítésének időpontjára?" Itt két szakaszt kell összekapcsolni, és csak együtt adják a választ.

Az adatkészletet nyilvánosan közzétettük a HuggingFace-en, hogy mások is használhassák: eu-tenders-with-questions-for-agentic-checklist-filling.
A hat versenyző
Mindhárom családból egy-egy példát valósítottunk meg, és két klasszikus baseline-nal vetettük össze őket. A baseline-ok egy kutatás során az alap értékek meghatározására szolgálnak, ehhez hasonlítjuk a komplexebb megoldásokat.
Módszer | Család | Röviden |
|---|---|---|
Baseline (szintaktikus) | A klasszikus kulcsszavas keresés, a szókészlet-átfedésen alapul | |
Dense keresés | Baseline (szemantikus) | multilingual-e5-large beágyazás (embedding) vektoros indexben |
Hibrid (DBSF) | Hibrid | BM25 és dense keresés (bge-m3), a két lista pontszámeloszlás-alapú fúziójával |
Hibrid + cross-encoder | Hibrid | A két jelöltlista uniója, cross-encoder rerankerrel újrarendezve |
Gráf | LLM-mel kinyert tényhármasokból épített gráf, a találatok bővítése a gráf mentén | |
Ágensalapú | Többlépéses keresés két kis, finomhangolt (fine-tuned) neurális hálózattal, Transformer-modellel (DeBERTa-v3) |
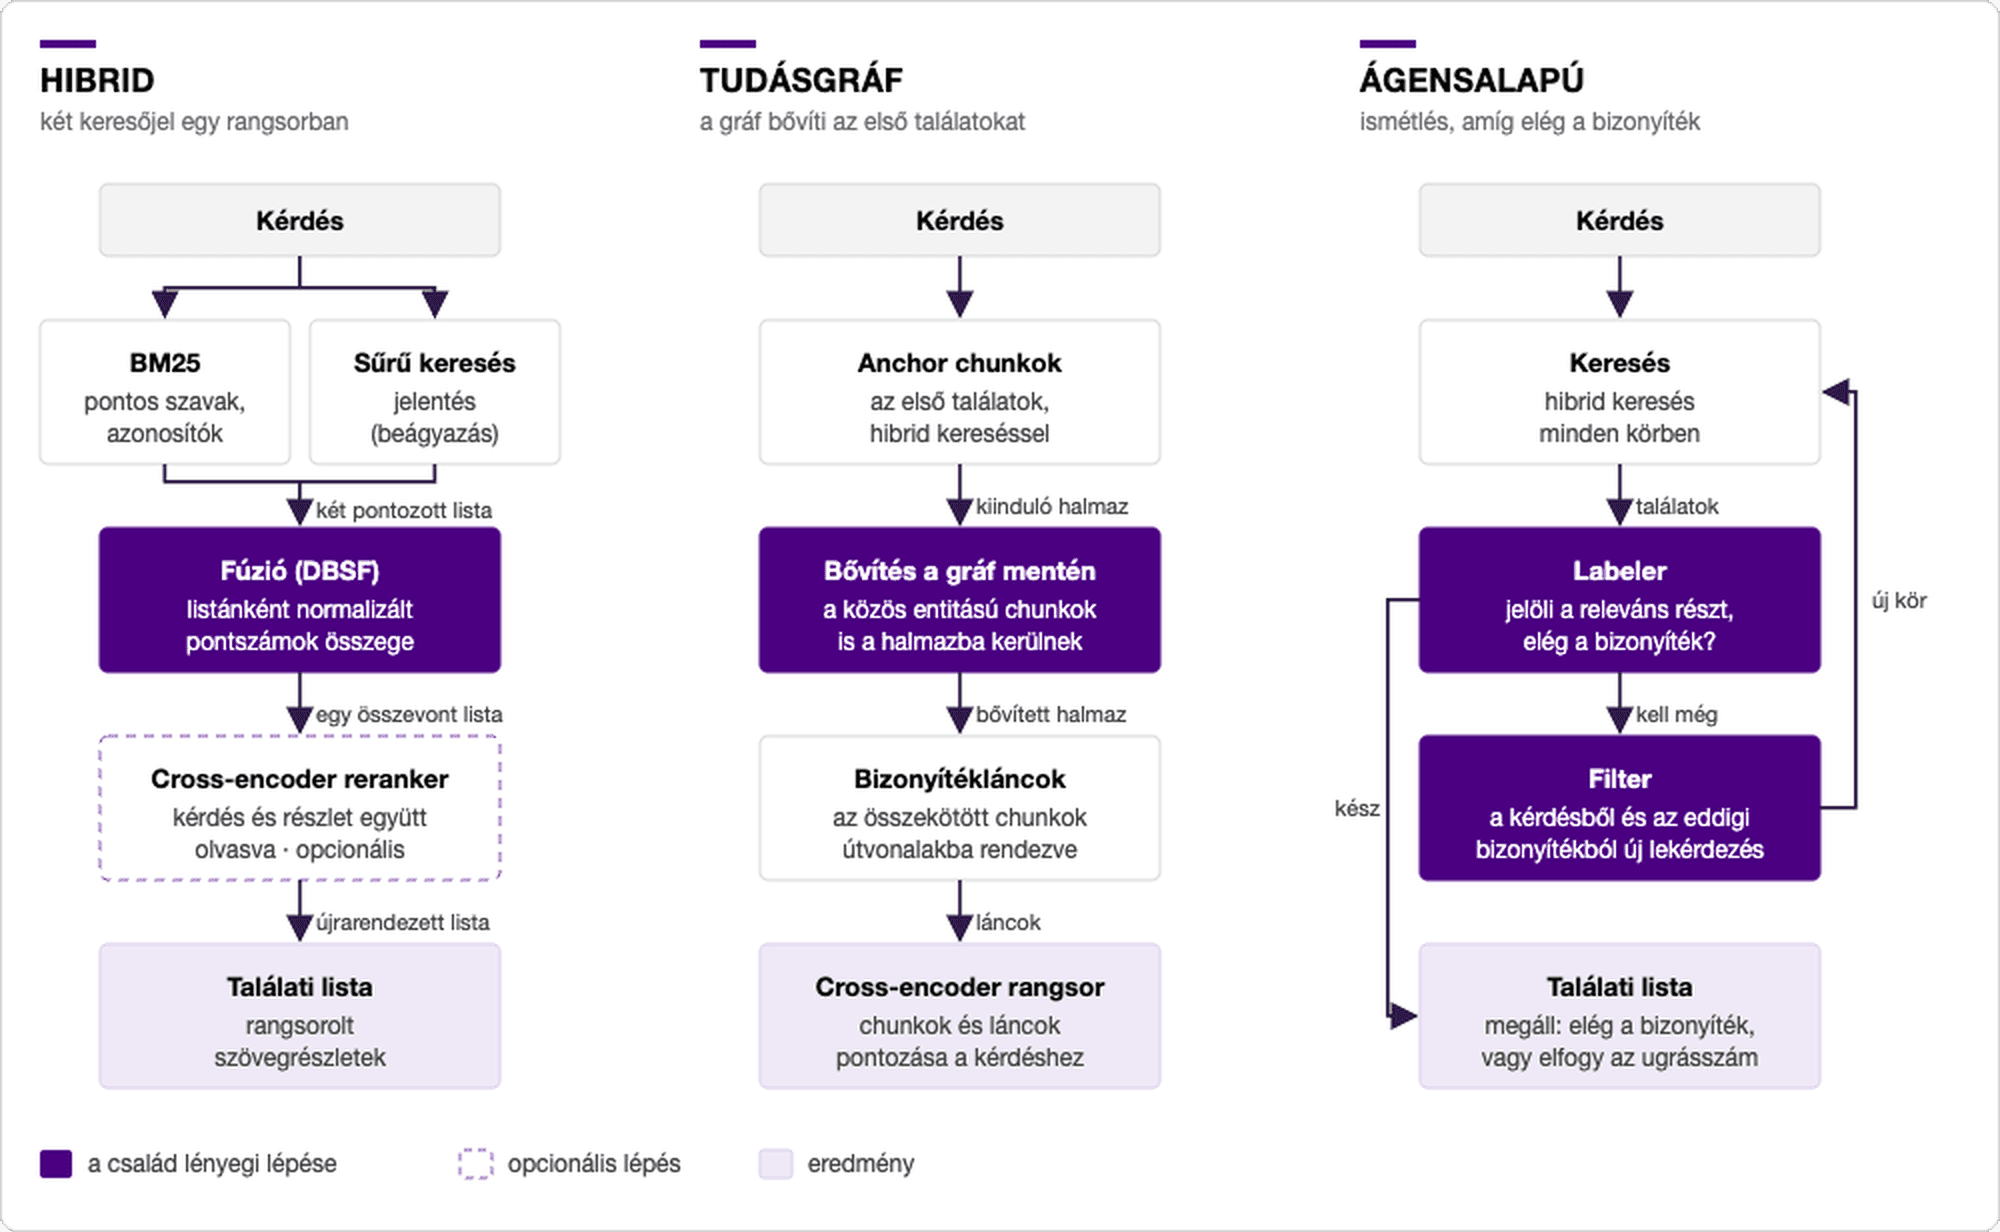
A szemantikus keresés (Semantic Search) a beágyazások közötti vektoros keresésre (Vector Search) épül, a BM25 pedig a szavak pontos egyezésére. A hibrid keresés lényege, hogy a két módszer pontszámai eltérő skálán mozognak, ezért fúzió előtt normalizálni kell őket. A DBSF (Distribution-Based Score Fusion) minden lista pontszámait a saját átlagával és szórásával normalizálja, majd összegzi, így nem kell fúziós súlyt beállítani. A cross-encoder reranker a kérdést és a szövegrészletet együtt olvassa, ezért pontosabb, de minden jelöltre külön lefut.
A KG2RAG kiindulásként kapcsolódó szövegrészeket keres (anchor), majd a gráfban közös entitások mentén bővíti a halmazt, végül bizonyítékláncokba rendezi és cross-encoderrel pontozza őket. A gráfot egy LLM építi few-shot prompttal, a szövegdarabokból kinyert tényhármasokból.
Az EfficientRAG az iteratív keresés LLM-hívásait két kis modellre cseréli. Az egyik (Labeler) megjelöli a releváns részeket, és eldönti, hogy elég-e már a bizonyíték. A másik (Filter) az eredeti kérdésből és az eddig összegyűjtött bizonyítékból fogalmazza meg a következő lépés keresőkérdését.
Két dolgot érdemes tisztán látni, mert mindkét módszer a cikk adaptációja, nem pontos másolata. A KG2RAG-nál az anchorokat az eredeti dense keresés helyett a hibrid keresés adja: a gráf csak olyan entitásokig tud eljutni, amelyek az anchorban szerepelnek, és ebben a korpuszban a BM25 erősebb volt, mint bármelyik önálló beágyazás, így a gyenge első lépés az egész rendszert lehúzta volna. Az EfficientRAG szerzői pedig nem tették közzé a tanított modelleket, ezért a sajátunkat kellett betanítanunk. Ez mindössze 200 szintetikus láncon történt, vagyis nagyjából 450-szer kevesebb adaton, mint az eredeti cikkben. Kipróbáltuk az eredeti cikkben szereplő pretraining adatokkal való tanítást, majd az azt követő fine-tuningot, viszont ez a módszer jelentősen rosszabb eredményt adott, mintha csak a saját adatainkon tanítottuk volna.
Hogyan mértünk?
Minden módszer a keresés végén 20 szövegrészletet adott vissza. Ezeken számoltuk a keresési mutatókat, elsősorban az nDCG-t, amely azt jutalmazza, hogy a releváns részletek minél előrébb kerüljenek a listában. Az első 10 részletet egy checklist-kitöltő LLM-ügynök kapta meg, amelynek ezekből kellett válaszolnia, vagy ki kellett mondania, hogy a dokumentumokban nincs válasz. Ez egyfajta védőkorlát (guardrail) a hallucináció ellen. A válaszokat egy LLM-bíró értékelte helyesség, megalapozottság (faithfulness) és tartózkodás szempontjából. Rögzítettük a késleltetést és a költséget is.
Mivel mindössze 97 kérdésünk van, a különbségeket párosított bootstrap konfidenciaintervallummal vizsgáltuk. Ez a poszt csak azokat a különbségeket tekinti valósnak, amelyek intervalluma nem tartalmazza a nullát. A gyakorlatban nagyjából 0,03 nDCG alatt minden eltérés zajnak számít.
Eredmények
A hibrid keresés erőssége
Az első meglepetés, hogy a hat módszerből négy gyakorlatilag azonos szinten van a keresési minőségben: a BM25, a hibrid keresés, a cross-encoderes változat és a KG2RAG. Papíron a gráfalapú KG2RAG érte el a legmagasabb nDCG-t, a hibrid keresés követi, de a kettő közti különbség messze a zajon belül van.
Megbízhatóan csak három dolog látszik:
A dense keresés önmagában gyengébb a BM25-nél. A közbeszerzési szövegek tele vannak pontos azonosítókkal, cikkszámokkal, definiált fogalmakkal és számokkal. Ezeket a lexikai keresés pontosan megtalálja, a beágyazások viszont könnyen összemossák őket.
A hibrid keresés (DBSF) az egyetlen módszer, amely megbízhatóan jobb (minden esetben legalább egyenlő eredmény) a BM25-nél, bár a nyereség kicsi. A két jel kiegészíti egymást, és a fúzióhoz nem kell tanított komponens.
A tanított EfficientRAG megbízhatóan gyengébb a BM25-nél.

A gráf nem talál több bizonyítékot
A KG2RAG ígérete, hogy a gráf mentén olyan szövegrészeket is megtalál, amelyeket a sima keresés elmulaszt. Az adataink szerint a gráf főleg átrendezi a találatokat: a találati rátája (recall) pontosan megegyezik a hibrid módszerével, vagyis nem talált több releváns szövegrészletet. A gráfban a második ugrás sem hozott többet, egy ugrás elég volt.
A tanított EfficientRAG gyors, de ebben a formában gyenge
Az EfficientRAG célja, hogy az LLM-alapú, iteratív keresés minőségét olcsón és gyorsan adja. A sebességgel nincs gond: lekérdezésenként másfél másodperc körül dolgozik, és futás közben nem kell API-hívás. A minősége viszont megbízhatóan elmarad a BM25-étől. Emellett kevesebb szövegrészletet ad vissza, mert leáll, amint elegendőnek ítéli a bizonyítékot, ezért a lefedettsége szerkezetileg alacsonyabb.
Fontos különbség, hogy a sebesség- és költségelőny architekturális, a minőségi hátrány viszont összefügg a nagyon kevés tanítóadattal. Ezért ebből nem az következik, hogy a tanított kis modellek általában rosszak, csak az, hogy ez a megvalósítás ennyi adattal nem versenyképes.
A válaszminőség laposabb
Végső soron nem a keresési rangsor számít, hanem az, hogy helyes és megalapozott-e a kitöltött checklist. Itt a kép laposabb: a cross-encoderes hibrid, a BM25 és a DBSF-hibrid névlegesen a legjobb, a gráfalapú módszer névlegesen kicsit gyengébb, de a BM25-höz képest egyik különbség sem megbízható, kivéve a tanított EfficientRAG-ét, amely gyengébb.
A megalapozottság mindegyik módszernél magas: a generátor ritkán lép túl a megadott szövegrészleteken. Ha a bizonyíték a kontextusban van, a hallucináció ebben a szűk feladatban ritka. A kritikus kérdés az, hogy a bizonyíték eljut-e oda.

A keresés felülről korlátozza a válasz minőségét
A módszerek összehasonlításán túl van egy általánosabb tanulság is. Amikor az összes szükséges szövegrészlet bekerült a generátornak átadott első tízbe, a válaszok átlagos helyessége nagyjából 0,90 volt. Ha csak néhány volt bent, 0,78 körül alakult, ha egy sem, akkor 0,68 körül. Az utolsó szám azt is mutatja, hogy a generátor gyakran tud válaszolni részleges vagy szomszédos kontextusból is, de a minőség egyértelműen a keresésen múlik.

Hol erős a gráf, és hol nem?
A kérdéstípusok szerinti bontás árnyalja a képet:
A KG2RAG az egydokumentumos következtetésnél a legerősebb, ahol egyetlen dokumentum több, közös entitásokon át összekapcsolódó tényét kell összerakni. Itt a találati mutatója érezhetően magasabb, mint a BM25-é.
A dokumentumok közötti kérdéseken a leggyengébb: itt a válaszhelyessége alacsonyabb, mint a BM25-é. Valószínű ok, hogy a gráf az anchorok entitásaiból indul ki, a kérdéshez viszont több dokumentumban lévő részletek kellenek, amelyeket egyetlen anchor sem köt össze.
A keresés minősége minden módszernél romlik az egyszerű keresési kérdésektől a többugrásos felé haladva.

A költség: itt dől el a verseny
A minőségkülönbségek kicsik, a költségkülönbségek viszont nagyságrendekben mérhetők:
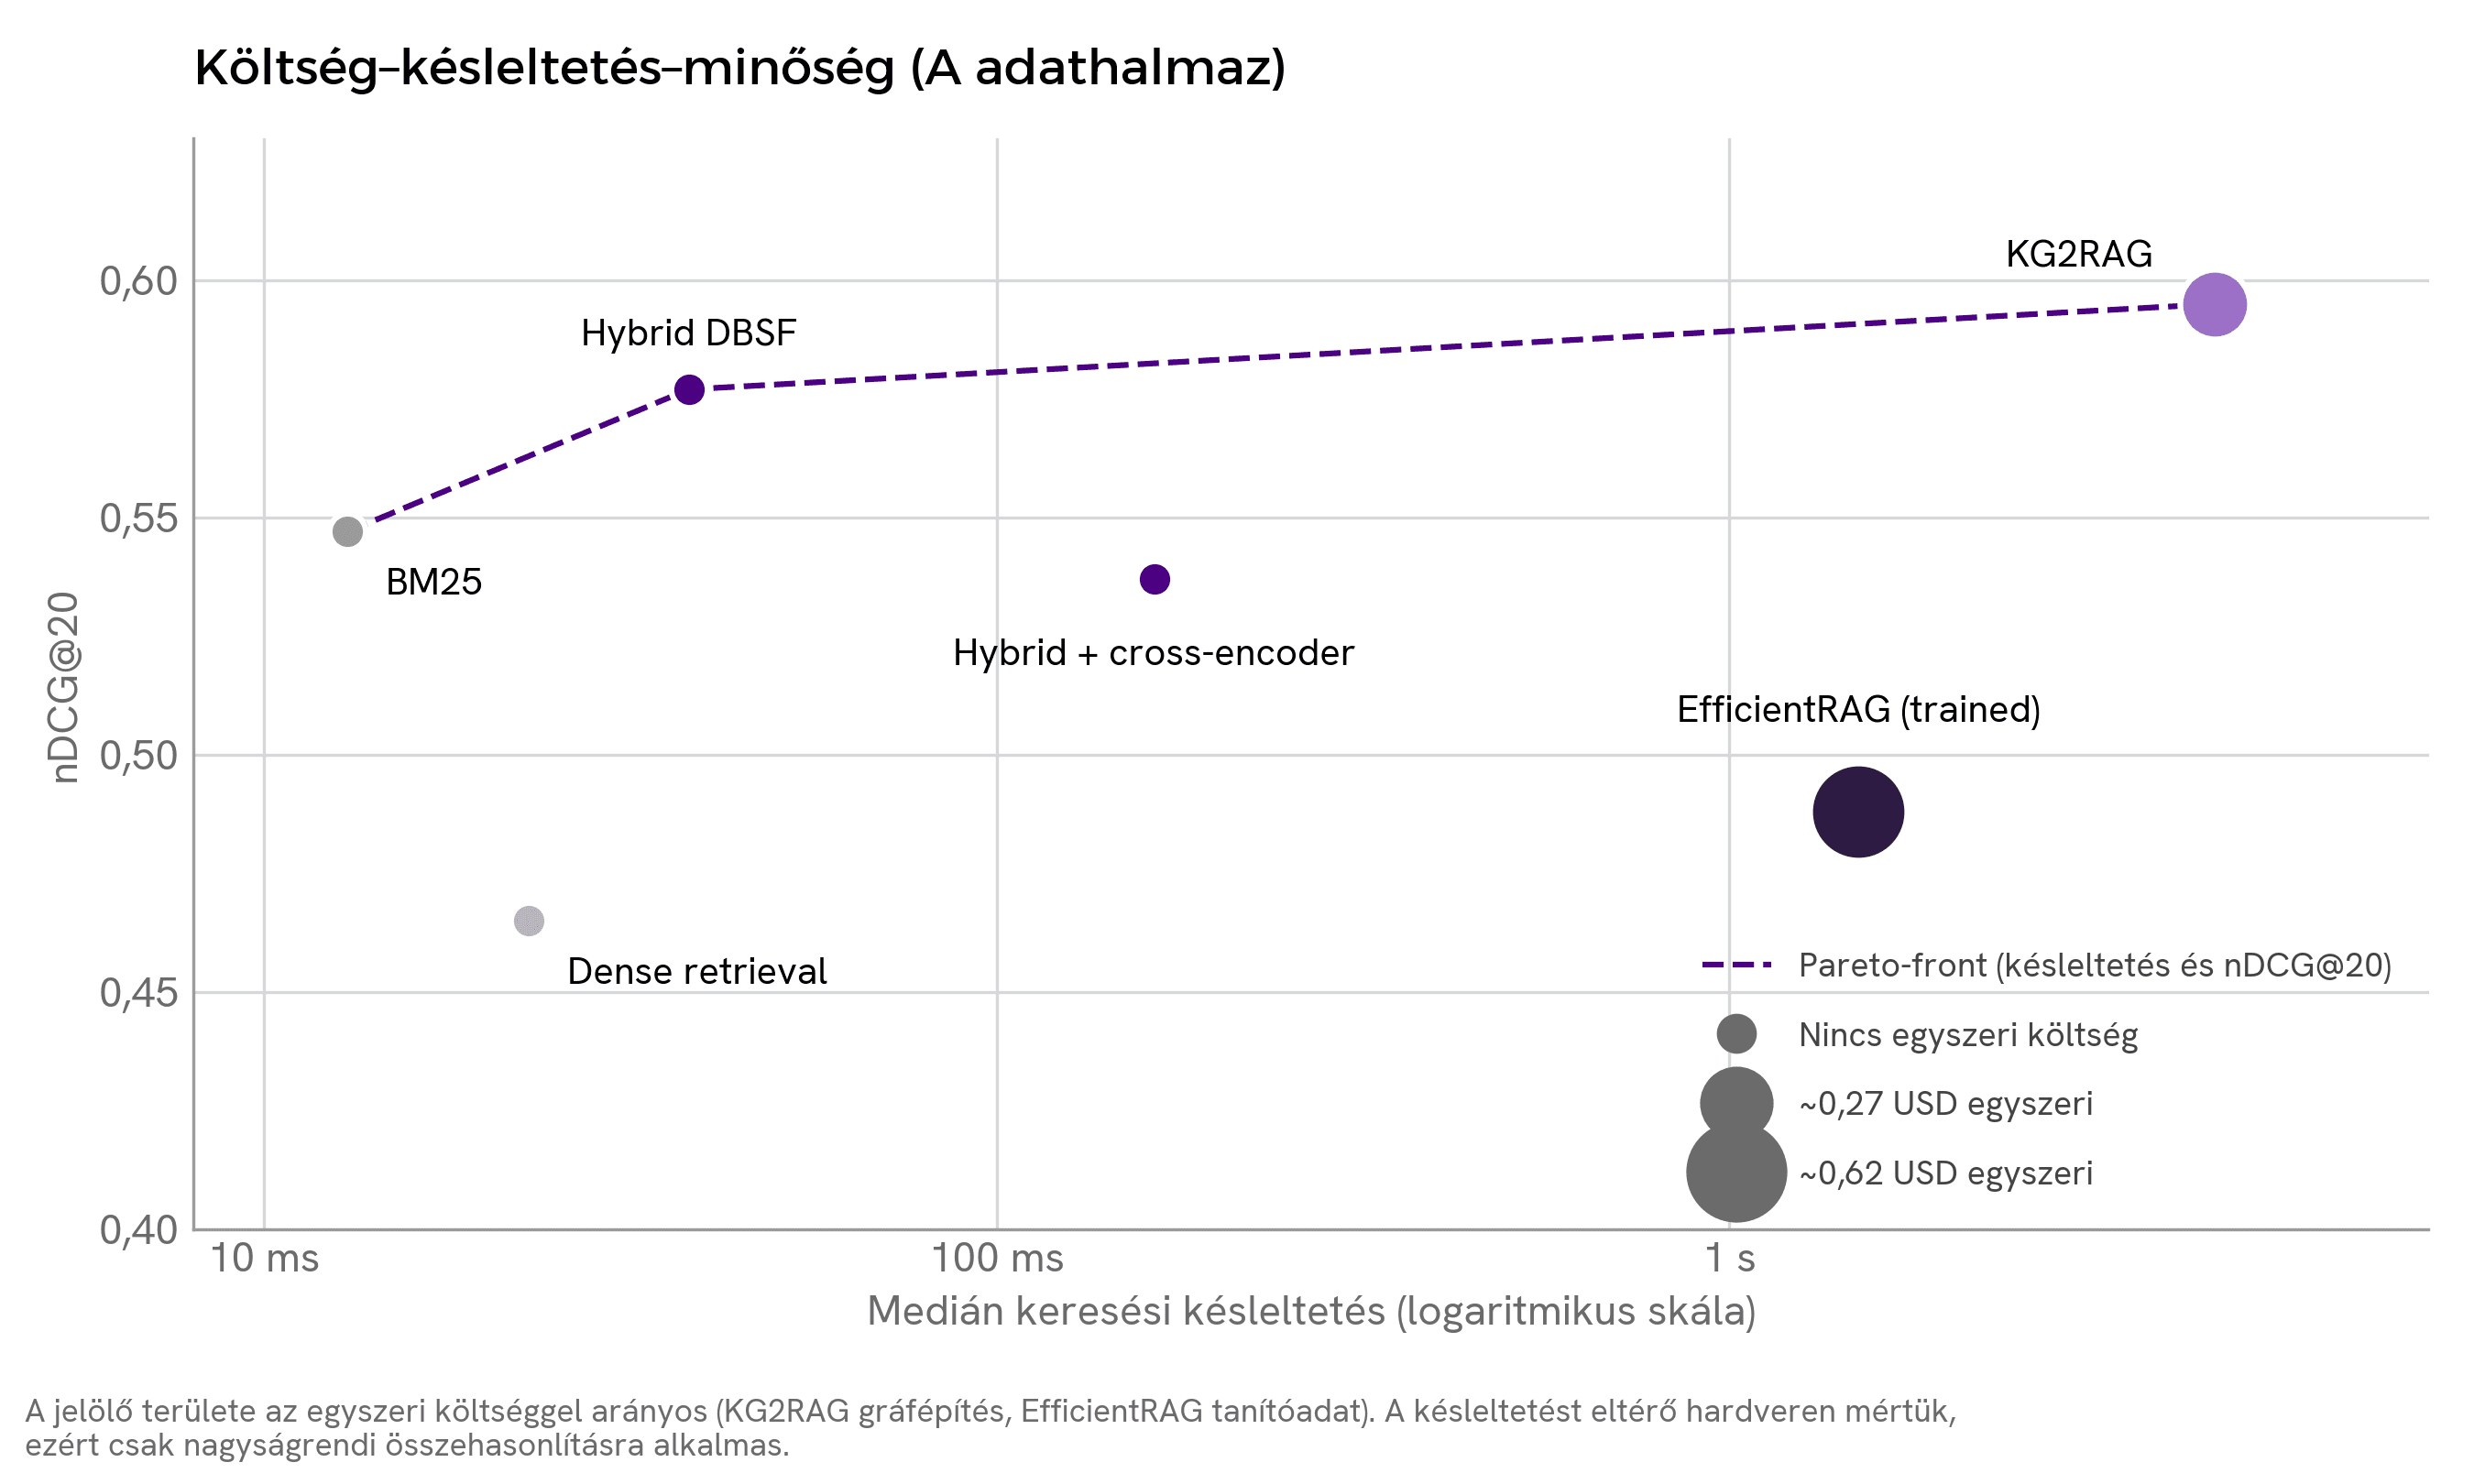
A hibrid keresés néhány tíz ezredmásodperc alatt válaszol, lekérdezésenként nincs API-költsége, csak egyszeri indexépítés kell hozzá.
A KG2RAG egyszeri gráfépítést igényel LLM-mel. A mi 1101 szövegdarabos korpuszunkon ez nagyjából 0,27 dollárt és nagyjából egy órát jelentett. Utána lekérdezésenként néhány másodperc a válaszidő, és új dokumentumoknál az építést meg kell ismételni.
A tanított EfficientRAG lekérdezésenként másfél másodperc körül dolgozik, és futás közben nem kell számolnunk API költséggel. A tanítóadat előállítása kevesebb mint egy dollárnyi API költség volt, de ehhez jön a modellek betanítása. A költség–minőség Pareto-frontot (azokat a módszereket, amelyeknél nincs egyszerre gyorsabb és jobb alternatíva) a mi adatainkon a BM25 és a hibrid keresés alkotja. Nagy dokumentumkészletnél és sok lekérdezésnél ez a skálázhatóság és pénzügyi megtérülés kérdése is.
Tanulságok
1. Kezdj hibrid kereséssel. A BM25 és a szemantikus keresés (vektoradatbázis, beágyazás) pontszám-fúziója az a megoldás, amelyet ebben a mezőnyben megbízhatóan nem sikerült legyőzni. A bevezetése klasszikus low-hanging fruit, és olcsón biztosít jó alapszintet. A fúzió módja kevésbé számít, mint az, hogy mindkét jel jelen legyen. Ráadásul átlátható is: mindig látszik, melyik keresőből melyik találat származik, ami a magyarázható MI (Explainable AI) szempontjából is előny.
2. A gráfot az erős első lépésre építsd, ne helyette. A KG2RAG hatékonyságát az első, anchorkereső lépés korlátozza. Egy tudásgráf (knowledge graph) csak annyit tud hozzátenni, amennyit az első lépés megtalált. A gráf akkor lehet érdemes, ha a kérdések egy dokumentumon belül több tény összekapcsolását igénylik, és az építési költség megtérül, például stabil, sokszor lekérdezett dokumentumkészletnél. Ahol folyamatosan érkeznek új dokumentumok, az újraépítés rontja a mérleget.
3. Egy módszert ne a saját cikke alapján válassz. Az EfficientRAG a cikkében LLM-szintű keresést ígér töredék költséggel. A mi adatainkon, a mi tanítóadatunkkal ez nem jött össze. A sebesség és az olcsó üzemeltetés valódi előny, de a minőséget a saját dokumentumaidon kell igazolni, mielőtt az ágensalapú vagy tanított megoldás mellett döntesz. Egy köztes, válogató réteg beépítése, ami a könnyű kérdéseket hibrid megoldással, a nehéz kérdéseket pedig ágensalapú kereséssel oldja meg, egy jó megoldást adhat, de ezt nem teszteltük.
4. Válaszszinten mérj, konfidenciaintervallummal. A keresési metrikák jó diagnosztikai eszközök, de a rendszert a végső checklist-minőség alapján kell kiválasztani. A kis különbségek könnyen félrevezetnek: a 0,03 nDCG alatti eltérés ezen a mintaméreten zaj. Érdemes a KPI-okat végponttól végpontig, a saját dokumentumokon mérni, és a szintetikus kérdések mellé valódi, szakértők által írt kérdéseket is gyűjteni. Ez az LLMOps-gyakorlat egyik alapja.
A döntést az alábbi táblázat foglalja össze.
Helyzet | Javaslat | Miért |
|---|---|---|
Új rendszer, másodpercen belüli válaszidő | Hibrid (BM25 + szemantikus keresés, DBSF) | Gyors, lekérdezésenként nincs API-költség, megbízhatóan nem vertük meg |
Tiszta, digitális dokumentumok, több tényt összekötő kérdések, stabil dokumentumkészlet | Hibrid, szükség esetén kiegészítve KG2RAG-gal | A gráf a következtetésekben erős, de a nyereség nem megbízható, és egyszeri építési költséggel jár |
Nagy lekérdezésszám, stabil terület, van tanítóadat | Tanított Labeler és Filter, csak saját adaton végzett kiértékelés után | Gyors és futás közben ingyenes, de nálunk gyengébb volt a BM25-nél |
Reranker vagy bármely tanított komponens | Mérd meg a saját mintán | A cross-encoder a válaszminőségben névlegesen a legjobb volt, a keresésben nem különbözött megbízhatóan a BM25-től |
Mire figyelj: a vizsgálat korlátai
Szeretnénk őszinték lenni abban is, mit nem tudunk. A benchmark 97 kérdésből áll, ami kicsi, ezért az „azonos szintű" eredmények a különbség hiányát jelentik, nem bizonyítják az egyenértékűséget. A kérdések és a referenciaválaszok LLM-generáltak, és csak mintavételesen ellenőriztük őket. Az ilyen kérdések hajlamosak átvenni a forrásszöveg szókincsét, így egy éles rendszer teljesítménye alacsonyabb lehet. A válaszokat generáló modell és az értékelő bíró ugyanaz az LLM, a futtatások pedig egyszeri futások voltak, emberi címkékkel való kalibráció nélkül.
Konklúzió
A visszakeresés minősége a RAG-alapú checklist-automatizálás (auditfolyamatok, dokumentumellenőrzés) szűk keresztmetszete, és ezt valódi dokumentumokon kell mérni. A mi uniós közbeszerzési benchmarkunkon a gondosan felépített hibrid keresés bizonyult a legjobb kiindulópontnak, ami gyors, olcsó, és a drágább architektúrák sem előzték meg teljesítményben. A gráf célzottan, a megfelelő kérdéstípusra alkalmazva térülhet meg, a tanított ágensalapú keresésről pedig csak a saját adatokon végzett mérés után érdemes dönteni. Érdemes a megoldást emberi felügyelettel (human-in-the-loop) is kiegészíteni, különösen megfelelőségi ellenőrzésnél, ahol a felelős MI szempontjai is számítanak.
A DocAudit termékünk pontosan az AI-alapú dokumentumellenőrzésre és feldolgozásra készült, ezeket a tanulságokat alkalmaztuk a fejlesztés során.
Ha MI-ügynököt vagy RAG-alapú dokumentumfeldolgozó rendszert építenél, és szeretnéd a saját adataidon megmérni, melyik architektúra éri meg, vedd fel velünk a kapcsolatot.
Kiss Tamás
Senior AI Engineer
Tamás teljes AI-projektek technikai megvalósítását vezeti a tervezéstől az implementáción át a fejlesztői és ügyféloldali koordinációig, gyakorlati AI-képzésekkel támogatva a tudásátadást.